硬體與本地大模型
兩台算力真翻倍?DGX Spark 雙機實測:MiniMax H3 影片生成、LLM 部署完整評測
多買一台 DGX Spark,會快,但很少剛好兩倍。生 AI 影片約快 1.8 倍:MiniMax H3 同一支 10 秒影片,一台 42 分鐘、兩台 23 分鐘;跑本地大模型,寫字快 1.83 倍,讀長文件只快 1.25 倍。第二台換到的常常比速度更有用:做影片的換到時間,跑大模型的換到空間(DeepSeek V4.1 Flash 兩台放得下幾乎沒縮水的 2-bit 版),兩樣都做的換到不用輪流。
這篇整理 AI 策略室〈兩台算力真翻倍?DGX Spark 雙機實測〉影片裡的每一個數字、出處和條件,加上兩台怎麼接、軟體怎麼選,適合已經有一台 DGX Spark、正在考慮第二台的人。還不熟這台機器,可以先看NVIDIA DGX Spark 是什麼。
兩台 DGX Spark 影片章節
| 時間 | 章節 |
|---|---|
| 0:00 | 多買一台,會快兩倍嗎? |
| 0:37 | 生 AI 影片:一台和兩台差多少? |
| 1:32 | 一邊寫腳本、一邊生影片,一台夠用嗎? |
| 2:13 | 跑本地大模型:寫字、讀字各快多少? |
| 3:32 | DeepSeek V4.1 Flash:一台放得下嗎? |
| 4:12 | 一路加到八台,能跑多大的 AI? |
| 4:46 | 兩台怎麼接:線、孔、交換器、軟體 |
| 5:55 | 第二台到底換到什麼? |
兩台 DGX Spark 會快兩倍嗎?一張表看完
紙面上,記憶體從 128GB 變 256GB,FP4 算力從 1 PFLOP 變 2 PFLOP(含稀疏的理論值,兩台相加)。實際上每一種工作快多少不一樣,差在兩台怎麼分工:
| 工作 | 一台 | 兩台 | 倍數 | 條件 |
|---|---|---|---|---|
| 生 AI 影片(MiniMax H3,同一支 10 秒) | 42 分 03 秒 | 23 分 07 秒 | 1.82 倍 | 720p、ComfyUI+DGX Monarch,作者實測 |
| 從零訓練小模型 | 8,741 字/秒 | 17,202 字/秒 | 1.97 倍 | 約 9 億參數,NVIDIA 實測 |
| 大模型寫字(一個人用) | 11.9 字/秒 | 21.7 字/秒 | 1.83 倍 | Qwen3.8 27B,NVIDIA 實測 |
| 大模型讀文件 | 2,635 字/秒 | 3,285 字/秒 | 1.25 倍 | 同上,8K 長度的輸入 |
| 16 個人同時問 | 每人 9 字/秒 | 每人 15 字/秒 | 約 1.7 倍 | 27B 模型、短問題 |
| llama.cpp 兩台輪流算 | 20.1 字/秒 | 19.6 字/秒 | 0.97 倍 | 上一代 DeepSeek V4 Flash 2-bit |
倍數最接近兩倍的,是兩台各算各的、最後才對答案的工作,例如訓練時每台放一整份模型、只同步結果。倍數最低的,是每一步都要等對方的工作。
生 AI 影片:MiniMax H3 一台和兩台差多少?
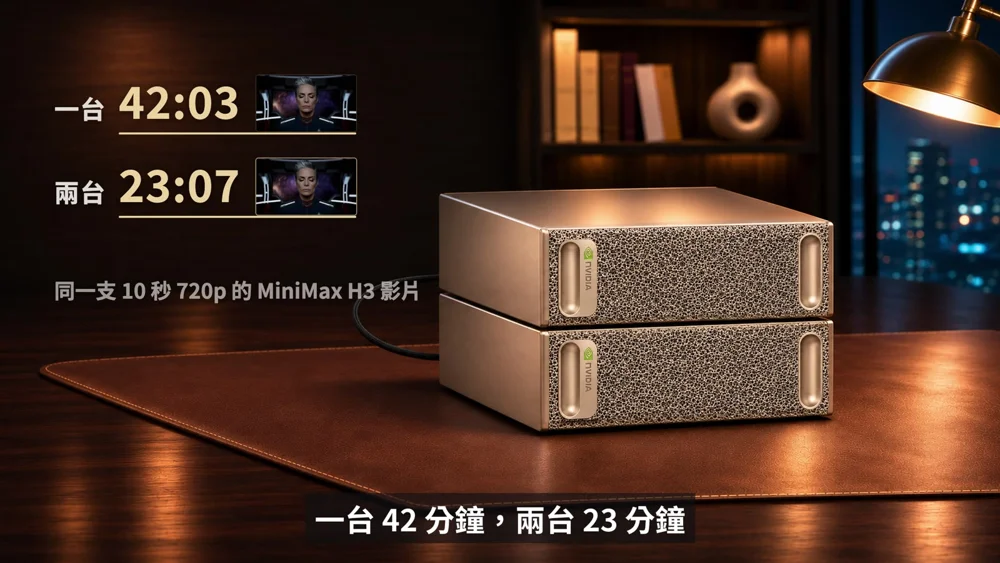
同一支 10 秒、720p 的 MiniMax H3 影片,一台 DGX Spark 要 42 分鐘,差不多一集影集;兩台一起算 23 分鐘,快 1.8 倍。這是 DGX Monarch 作者的實測:兩台用一條 200G 線直連,ComfyUI 加 DGX Monarch,把同一支影片拆給兩台一起算。社群另外重跑,兩台在 1.56 到 1.64 倍之間;四台一起算,5 秒的 H3 是一台的 2.5 倍以上。
要一天多出幾支片,兩台一起算反而比較少
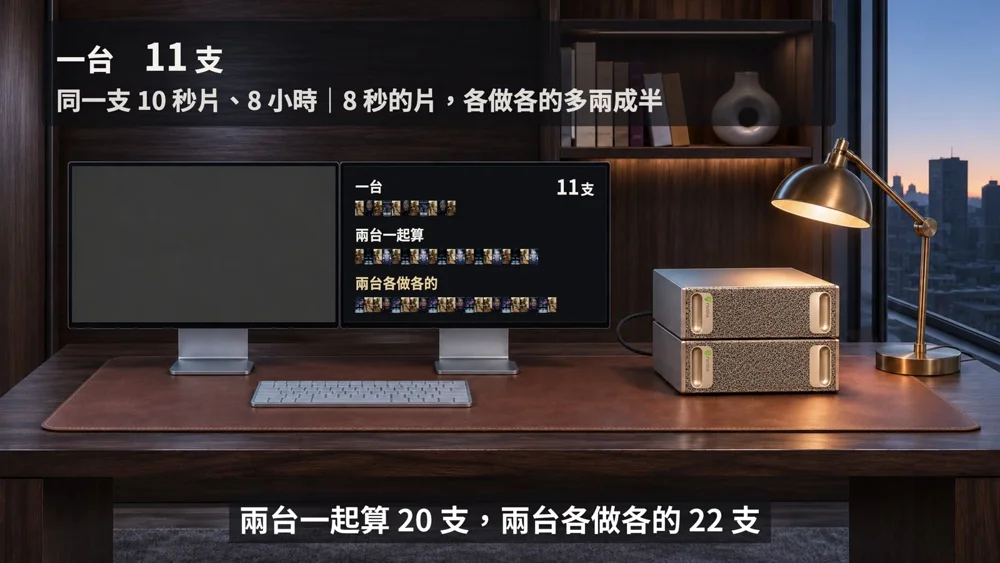
兩台一起算是讓「一支」等得比較短。要的是量,兩台各做各的比較多:下班前丟進去,隔天早上收。
| 8 小時做法 | 10 秒 H3 影片產量 |
|---|---|
| 一台 | 11 支 |
| 兩台一起算每一支 | 20 支 |
| 兩台各做各的 | 22 支 |
趕一支急件就一起算,要量就各做各的。產量是用單支時間算出來的(8 小時÷每支時間),各做各的多出約一成。
兩台能一次生更長的 AI 影片嗎?
一次能生多長,是模型決定的。H3 最長 15 秒,一台 Spark 就生得出來;要 20 秒,就換 LTX。LTX 官方多卡文件也寫明:多卡是縮短等待的工具,不是用來放更大模型的。兩台唯一多做到的,是記憶體剛好不夠的時候:不壓縮的原版 H3(BF16),一台跑兩次都爆,兩台跑完;壓縮版一台就跑得動,可以參考DGX Spark 搭 MiniMax H3 的短影片平台,顯卡上的做法看RTX 5080 跑 HyperFlow H3 教學。
一邊用 AI 寫腳本、一邊生影片,一台夠用嗎?
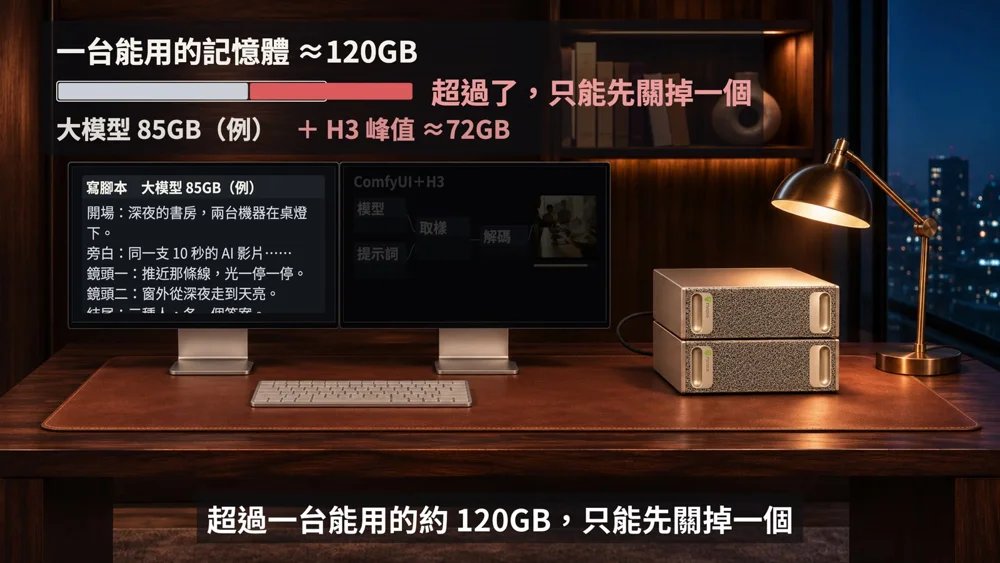
不夠,這是很多人買第二台真正的理由。每台 DGX Spark 實際能用的記憶體約 120GB。社群的例子:常駐一個 85GB 的大模型寫腳本,再加上 H3 生影片峰值約 72GB,加起來超過一台,只能先關掉一個。NVIDIA 開發者論壇的版主也這樣建議:一台跑 ComfyUI,一台跑大模型。
第二台換到的,是不用再輪流。這種一台模型、一台影片的分工,兩台不用串聯軟體,各自照單台裝就好;不想自己裝,可以看DGX Spark 自己裝還是找人裝。
跑本地大模型:為什麼寫字快 1.83 倍、讀文件只快 1.25 倍?
因為兩台把模型切成兩半、各算一半,每算完一層都要停下來對答案;讀文件時這段等待佔的比例最大。NVIDIA 的實測:Qwen3.8 27B 一個人用,寫字從每秒 11.9 個字變 21.7 個,1.83 倍;讀一份 8K 長度的文件,只從每秒 2,635 個字變 3,285 個,1.25 倍。
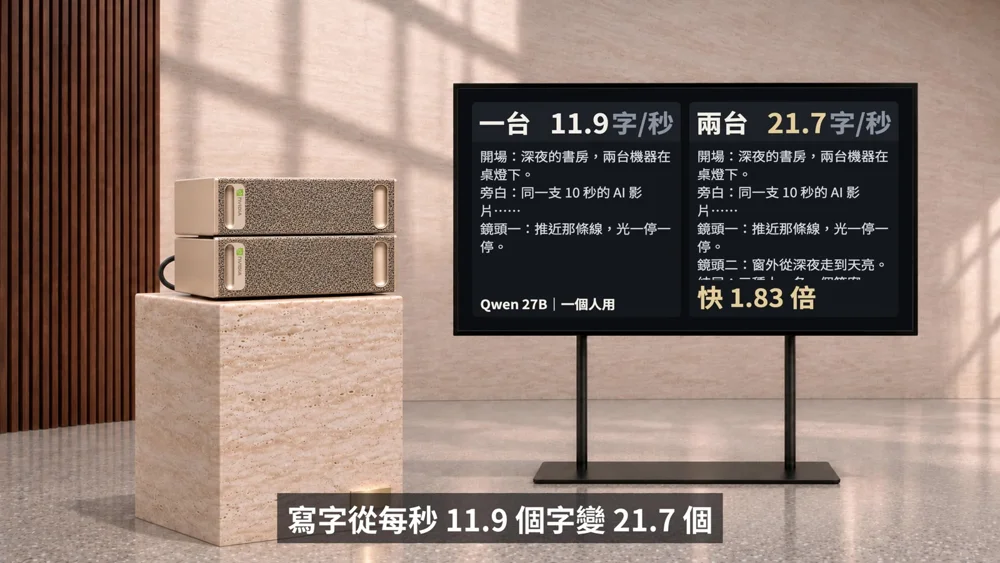
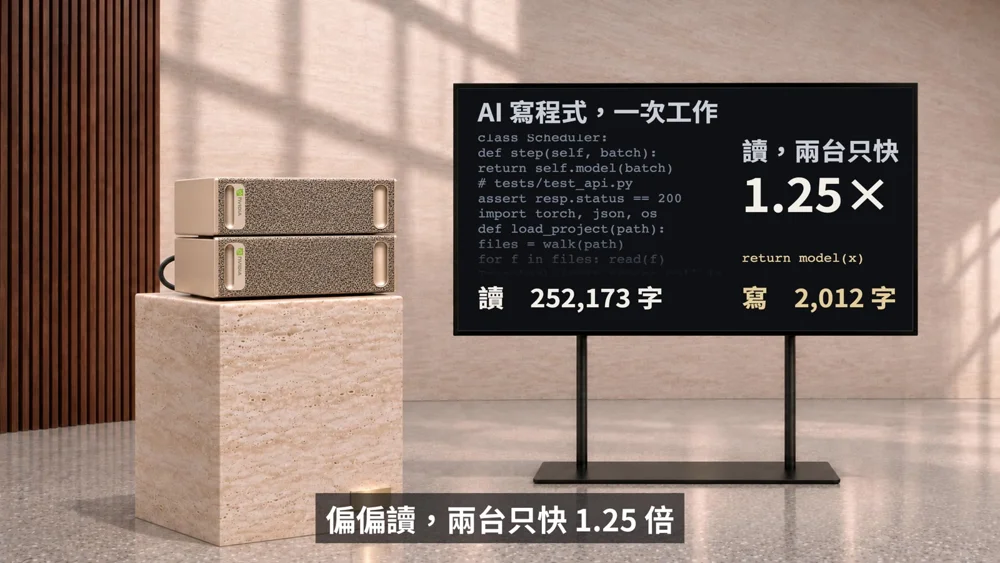
寫字時,模型每一步都要把整份權重從記憶體讀一遍,兩台各讀一半,記憶體頻寬等於加倍,所以最有感。讀文件時,模型一次處理一大段字,吃的是算力;27B 模型有 64 層,每一層算完都要透過背後那條線和另一台同步,等待的時間就把加倍的算力吃掉了。AI 寫程式時,模型讀的字常是寫的一百多倍(一次工作讀 252,173 字、寫 2,012 字),所以對寫程式的人,1.25 倍才是比較接近的感受。
機器裡的記憶體頻寬是 273GB/s,兩台之間的線實測約 23GB/s,差了約 11 倍;但片中引用的量測顯示,這條線大多時候其實閒著,卡住的是每一層停下來等對方的時間,換更快的線改善有限。人多的時候兩台比較有感:16 個人同時問,一台每人每秒 9 個字,兩台 15 個字。
tensor parallel 還是 pipeline?llama.cpp 和 vLLM 差在哪
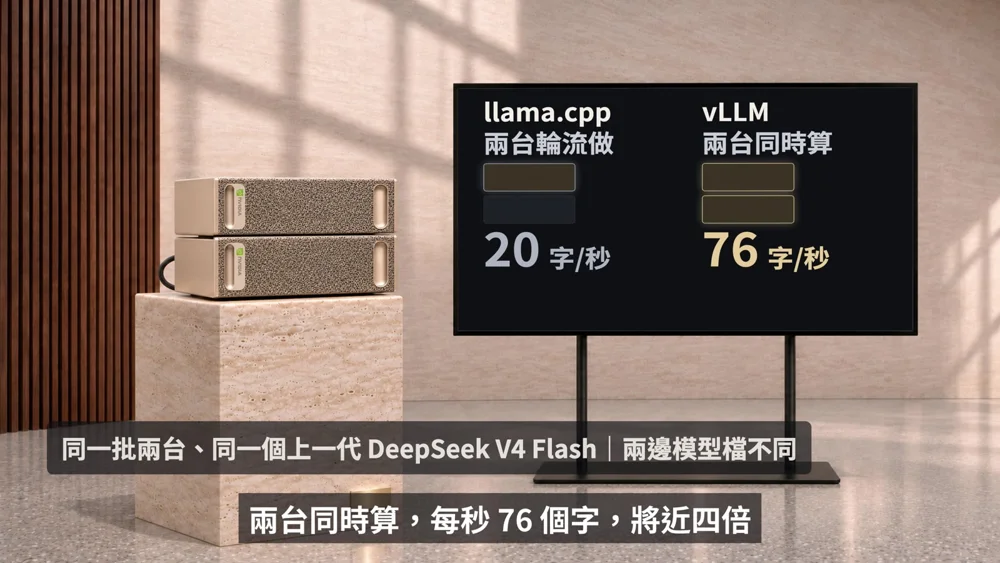
同樣兩台,換一種接法,速度可以差將近四倍。Classmethod 用同一批兩台、同一個上一代 DeepSeek V4 Flash 實測:llama.cpp RPC 把模型的層分給兩台輪流做(pipeline),每秒約 20 個字,跟一台差不多,還慢一點(0.97 倍);換 vLLM,每一層都切開、兩台同時算(tensor parallel),每秒 76 個字。而且 vLLM 跑的這個官方版,一台根本放不下。兩邊用的模型檔壓縮程度不同,但方向很清楚:兩台要變快,要選兩台同時算的引擎。
本地大模型工具怎麼挑,可以再看Ollama、LM Studio、vLLM 比較。
DeepSeek V4.1 Flash:一台 DGX Spark 放得下嗎?
塞得進去,但要壓到 1-bit;兩台放得下幾乎沒縮水的 2-bit 版。DeepSeek V4.1 Flash 在第三方的寫程式代理測驗(Terminal-Bench 4.0)和 Claude Haiku 5.5 同一個等級。官方檔約 510GB,其中約 200GB 是可以放在 SSD 的查表;剩下要放進記憶體的部分,bit 數就是壓縮程度,越少越小,也越容易變笨。Unsloth 同一份六項測驗:
| 放法 | 需要的記憶體 | 六項測驗平均 |
|---|---|---|
| 官方原版 | 約 510GB(約 200GB 查表可放 SSD) | 87.7 |
| 兩台:2-bit 版 | 約 200GB | 87.5 |
| 一台:1-bit 版 | 約 122GB | 83.5 |
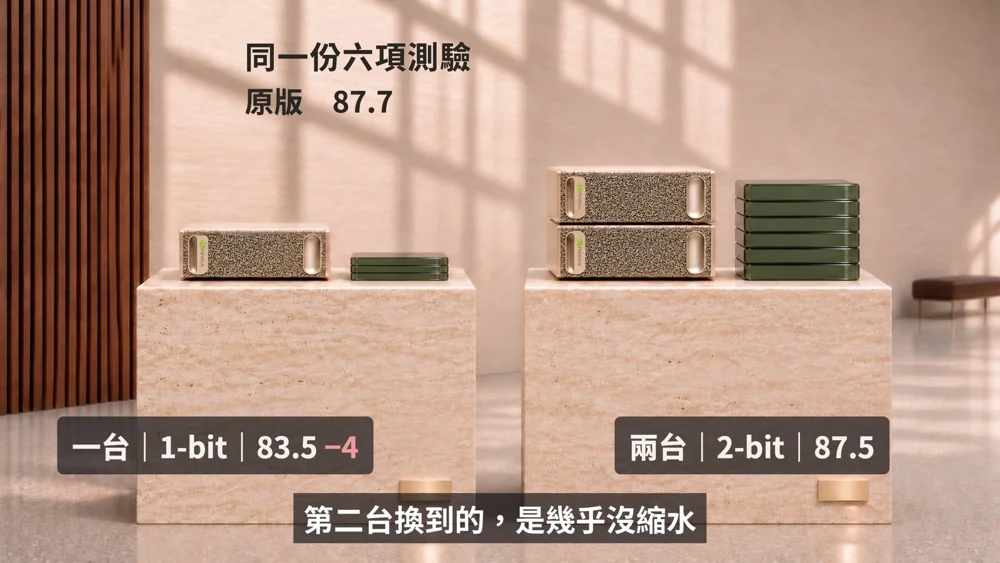
一台的 1-bit 掉 4 分,兩台的 2-bit 只差 0.2 分。第二台換到的,是幾乎沒縮水;壓到約 3-bit、軟體選對,兩台寫程式每秒上百個字(社群實測 64 到 118 字/秒)。
一路加到八台:DGX Spark 串聯能跑多大的 AI?
台數先換到放得下,再換到放原版。NVIDIA 2026 年 10 月宣布正式支援八台串聯,統一記憶體合計 1TB。用 DeepSeek V4.1 Flash 一路加上去:
| 台數 | 記憶體合計 | DeepSeek V4.1 Flash 放得下哪一版 | 寫程式速度 |
|---|---|---|---|
| 一台 | 128GB | 塞得進,但要壓得比 2-bit 還扁 | — |
| 兩台 | 256GB | 2-bit 版,幾乎沒縮水 | 約 3-bit、選對軟體可上百字/秒 |
| 三台 | 384GB | 第一次放得下原版,每台只剩幾 GB | 73 字/秒 |
| 四台 | 512GB | 原版跑得寬鬆 | 95 字/秒 |
| 八台 | 1TB | 原版,還有大量空間 | 133 字/秒 |
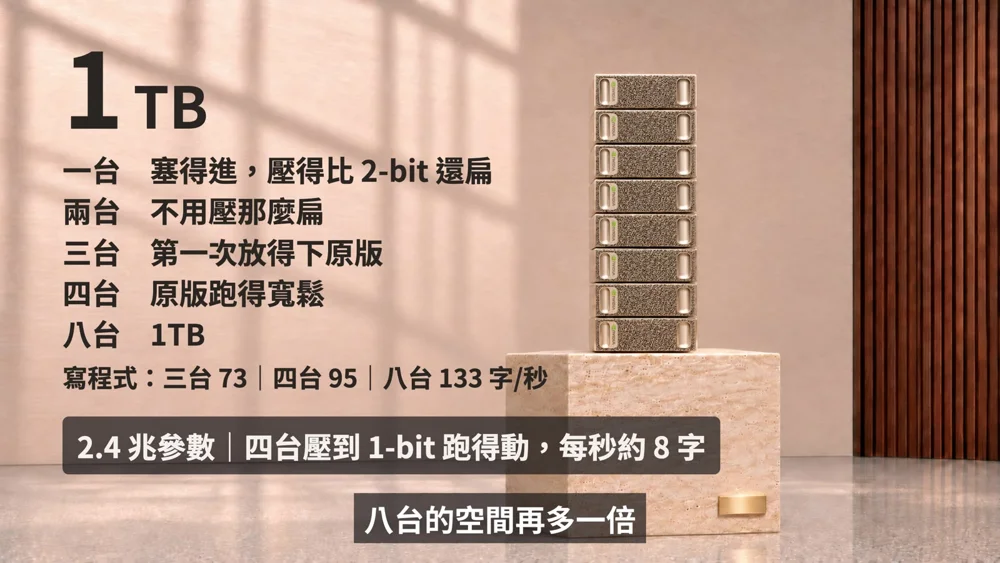
三到八台的寫程式速度是 NVIDIA 論壇同一位作者用同一版設定量的,開了推測解碼。1TB 桌上能跑多大的 AI?2.4 兆參數的 Qwen3.8,四台壓到 1-bit 就跑得動,每秒約 8 個字;八台的空間再多一倍。
兩台 DGX Spark 怎麼接?線、孔、交換器、軟體
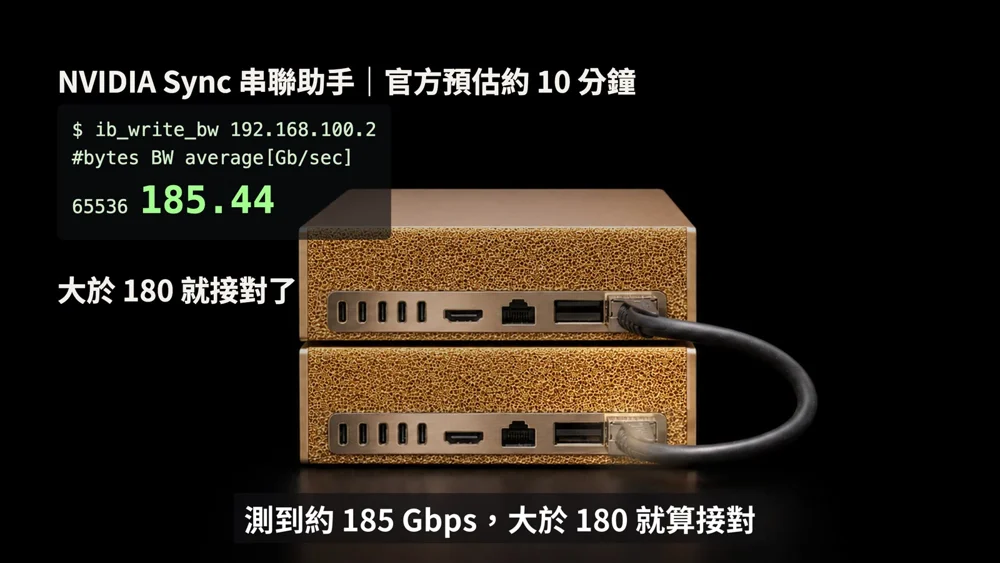
一條線對插,用 NVIDIA Sync 的串聯助手,官方預估約 10 分鐘。背後有兩個孔,很多人兩個都插,以為會更快;NVIDIA 官方說得很直接:兩台插兩條,不會變快。
| 問題 | 答案 |
|---|---|
| 要幾條線? | 一條。兩台插兩條不會變快,每台網路上限約 200G,一條就用滿 |
| 買哪種線? | NVIDIA 產品頁列的 QSFP112 DAC;200G、400G 都能用,買 400G 不會更快 |
| 第二個孔做什麼? | 串第三台:三台不用交換器,接成一圈 |
| 四台以上? | 接交換器;選 400G 的,一個孔可以分給兩台,每台還是 200G |
| 怎麼設定? | NVIDIA Sync 的串聯助手,官方預估約 10 分鐘 |
| 怎麼確認接對? | 速度測試約 185 Gbps,大於 180 就算接對 |
| 只測到十幾、二十幾 G? | 照官方指南把兩台都更新到同一版系統(含網卡韌體) |
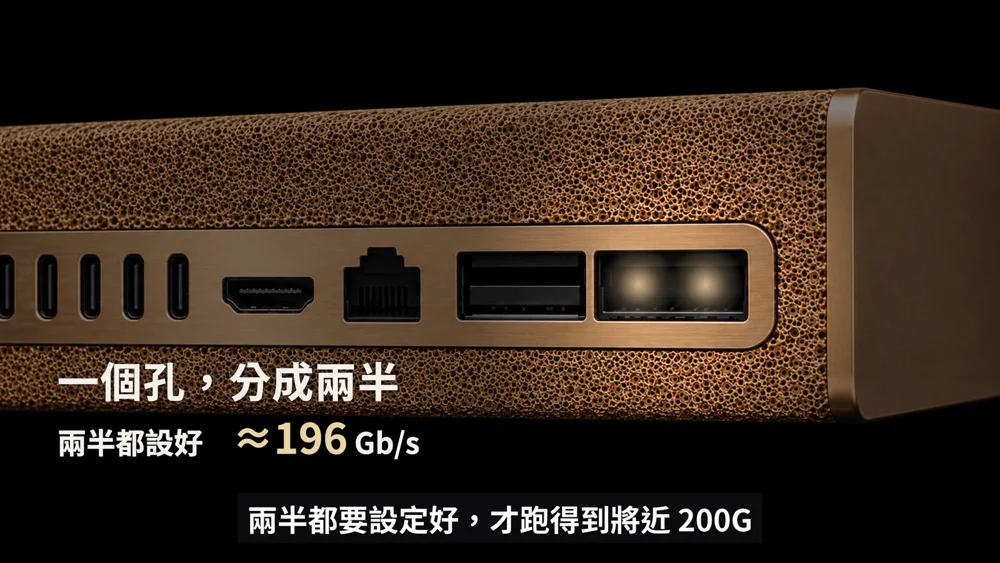
一個孔裡其實分成兩半,兩半都要設定好,才跑得到將近 200G;只用到一半,只剩一百出頭。串聯助手會幫你設好,最後跑一次速度測試確認。
兩台 DGX Spark 要裝什麼軟體?
| 用途 | 軟體 |
|---|---|
| 跑大模型 | vLLM 或 SGLang(tensor parallel,兩台同時算每一層) |
| 生 AI 影片 | ComfyUI 加 DGX Monarch(兩台一起算同一支影片) |
| 一台模型、一台影片 | 各自照單台裝,不用串聯軟體 |
第二台 DGX Spark 到底換到什麼?
回到開頭的問題:多買一台,會快兩倍嗎?會快,但很少剛好兩倍;第二台換到的,常常比速度更有用。
- 做影片的,換到時間:同一支 H3 影片 42 分鐘變 23 分鐘;要量就兩台各做各的。
- 跑大模型的,換到空間:一台放不下的模型放得下,DeepSeek V4.1 Flash 從 1-bit 換成幾乎沒縮水的 2-bit。
- 兩樣都做的,換到不用輪流:一台開著大模型寫腳本,一台生影片。
還在比較一台 Spark 和其他機器,可以看DGX Spark vs Mac Studio M5、DGX Spark vs RTX Spark。
兩台 DGX Spark 串聯常見問題
兩台 DGX Spark 串聯,速度會變成兩倍嗎?
很少剛好兩倍。從零訓練小模型最接近,1.97 倍;MiniMax H3 生同一支 10 秒影片約 1.8 倍(42 分鐘變 23 分鐘);27B 模型寫字 1.83 倍,讀長文件只快 1.25 倍。用 llama.cpp RPC 把模型分給兩台輪流算,甚至是 0.97 倍,比一台還慢一點。
兩台 DGX Spark 能當成一台 256GB 來跑大模型嗎?
記憶體加起來是 256GB(每台實際可用約 120GB),可以把一台放不下的模型切開放在兩台上跑,例如 DeepSeek V4.1 Flash 的 2-bit 版約需 200GB,一台放不下、兩台放得下。但它不是一塊合在一起的記憶體,兩台每算完一層都要透過網路線同步,所以要用 vLLM、SGLang 這類支援 tensor parallel 的引擎。
DGX Spark 背後兩個網路孔都插線,兩台會比較快嗎?
不會。NVIDIA 官方寫明兩台插兩條線不會提升效能:每台的網路上限大約 200G,一條線就能用滿。第二個孔是串第三台用的,三台可以不用交換器接成一圈。
兩台 DGX Spark 跑大模型,用 llama.cpp 還是 vLLM?
要速度用 vLLM 或 SGLang。同一位作者、同一批兩台、同一個上一代 DeepSeek V4 Flash:llama.cpp RPC 兩台輪流算每秒約 20 個字,和一台差不多;vLLM 每一層切開、兩台同時算,每秒約 76 個字。兩邊的模型檔壓縮程度不同,但差距主要來自分工方式。
兩台 DGX Spark 能生成更長的 AI 影片嗎?
一次能生多長是模型決定的:MiniMax H3 最長 15 秒、LTX 可到 20 秒,一台 DGX Spark 就生得出來。兩台是讓同樣長度等得比較短,不是讓片子變長;只有記憶體剛好不夠時,例如不壓縮的原版 H3,一台跑不完、兩台才跑得完。
DGX Spark 最多可以串幾台?
NVIDIA 2026 年 10 月宣布正式支援八台串聯,統一記憶體合計 1TB;NVIDIA Sync 的串聯助手目前支援兩到四台,八台的支援官方預計年底前加入。三台可以不用交換器接成一圈,再多就要接交換器。
資料來源
本文依 AI 策略室 2026 年 11 月 19 日影片整理;數字取自 NVIDIA 官方、開發者論壇與社群公開實測,下面是原始出處。
- NVIDIA DGX Spark 產品頁(規格、核可線材、串聯 FAQ)
- NVIDIA 技術部落格:八台 DGX Spark 串聯(訓練、寫字、讀文件倍數)
- DGX Monarch:兩台 ComfyUI 生成 MiniMax H3 的作者實測
- NVIDIA 開發者論壇:DGX Monarch 社群兩台、四台重跑
- gb10-comfyui-tuning:四台與每台各做各的產量
- ai-muninn:一台 DGX Spark 生 15 秒 H3(記憶體峰值約 72GB)
- Lightricks LTX-2 多卡文件
- NVIDIA 開發者論壇:一台跑 ComfyUI、一台跑大模型
- Openzeka:27B 模型多人同時使用的兩台實測
- Classmethod:兩台 DGX Spark 跑 DeepSeek V4 Flash(llama.cpp RPC 對 vLLM)
- Unsloth:DeepSeek V4.1 Flash 各壓縮版的記憶體需求與分數
- Artificial Analysis:DeepSeek V4.1 Flash 對 Claude Haiku 5.5
- Mia’s AI Lab:兩台跑 DeepSeek V4.1 Flash 1017
- NVIDIA 開發者論壇:DeepSeek V4.1 Flash 三台、四台、八台設定
- 四台 DGX Spark 跑 2.4 兆參數模型
- NVIDIA 官方指南:連接兩台 DGX Spark
- NVIDIA Sync 串聯助手文件
- Dataiku:兩台 DGX Spark 網路只有 26Gbps 的原因與修法
想把兩台 DGX Spark 的環境整套裝好:一台跑大模型、一台跑 ComfyUI,或兩台串成一組跑更大的模型,可以看奧微 DGX Spark 部署與 AI 軟體工作台,或透過 LINE 和奧微聊聊,說明是看 AI 策略室來的,享折扣。
回文章列表