
第九章
Agent 的持續進化
今天的 Agent 面臨一個鮮明的能力悖論:它可以零樣本解決從未見過的複雜任務,卻可能在處理了一萬次相似任務之後,第二天仍然犯下第一天的錯誤。模型上崗之後,能否像新員工一樣從日常工作中不斷長進?能否自主從經驗中學習(所謂持續學習,continual learning),正在成為 Agent 從「會完成任務」走向「能夠可靠工作」的關鍵能力,也是下一代模型的核心研究課題。今天的 「持續學習」 概念與早年 「學了新任務就忘掉舊任務」 的持續學習研究不是同一個問題,遺忘只是其中一個子問題,更難的是沒有人告訴模型,今天這一天的經歷裡哪些是做對的,哪些是做錯的。就目前而言,模型本身的持續學習能力仍遠遠不夠。
原因在於,部署後的模型並不會因為一次推理自動改變參數。第二章討論的上下文學習、狀態維護和壓縮,能讓 Agent 在目前任務內適應;但上下文結束後,這種變化不會自然進入下一次任務。把對話存進記憶也不等於學會了新的行為:原始軌跡可能很長,其中既有有效策略,也有偶然成功、錯誤歸因和不可信輸入。
這裡有一個容易混淆的區別:儲存經歷不等於從經歷中學習。把一百條軌跡放進長上下文或向量庫,可以幫助模型在需要時找回某個案例,卻不會自動完成跨案例比較——哪些步驟在成功軌跡中反覆出現,哪些做法只在舊版介面上有效,某次成功究竟來自正確策略還是環境偶然。學習發生在系統主動完成「評價、對照、歸納、驗證」之後,而不是發生在日誌寫入磁碟的那一刻。第三章的使用者記憶主要沉澱「使用者與世界是什麼樣的」,本章的經驗學習則要進一步沉澱「在什麼條件下應該怎樣行動」;前者讓 Agent 記得更多,後者才讓它從聰明變得熟練。
那麼,為什麼不讓模型在每次任務後直接訓練自己?因為生產環境很少提供乾淨的學習訊號。使用者滿意不意味著合規;局部參數更新還可能造成能力遺忘、策略漂移或安全退化。若允許模型依據未經驗證的回饋直接修改自身參數,錯誤經驗和提示注入就可能被固化,並在後續任務中持續放大。另一方面,基礎模型的週期性訓練可以提升通用能力,卻無法及時吸收每個 Agent 每天遇到的私有規則、工具變化和局部經驗。
因此,在模型自身尚不能可靠地持續學習時,必須先把 「學習」 建構成模型外圍的一套自主系統,本書稱之為持續進化,以區別於模型權重層面的持續學習:記錄執行證據,驗證結果與過程,從多條軌跡中擷取共性,再決定應更新知識、指令、程式還是模型參數。所有修改先形成待驗證版本,經過迴歸測試和安全檢查後,才能改變下一輪執行。
前面的章節已經給出了這套系統所需的主要部件。第二章處理任務內狀態,第三章提供知識基礎設施,第五章賦予 Agent 創造工具和修改系統的元能力,第七章建立評估與驗證,第八章說明如何更新模型參數。第九章的任務,是把這些部件組織成圖9-1所示的持續進化閉環。
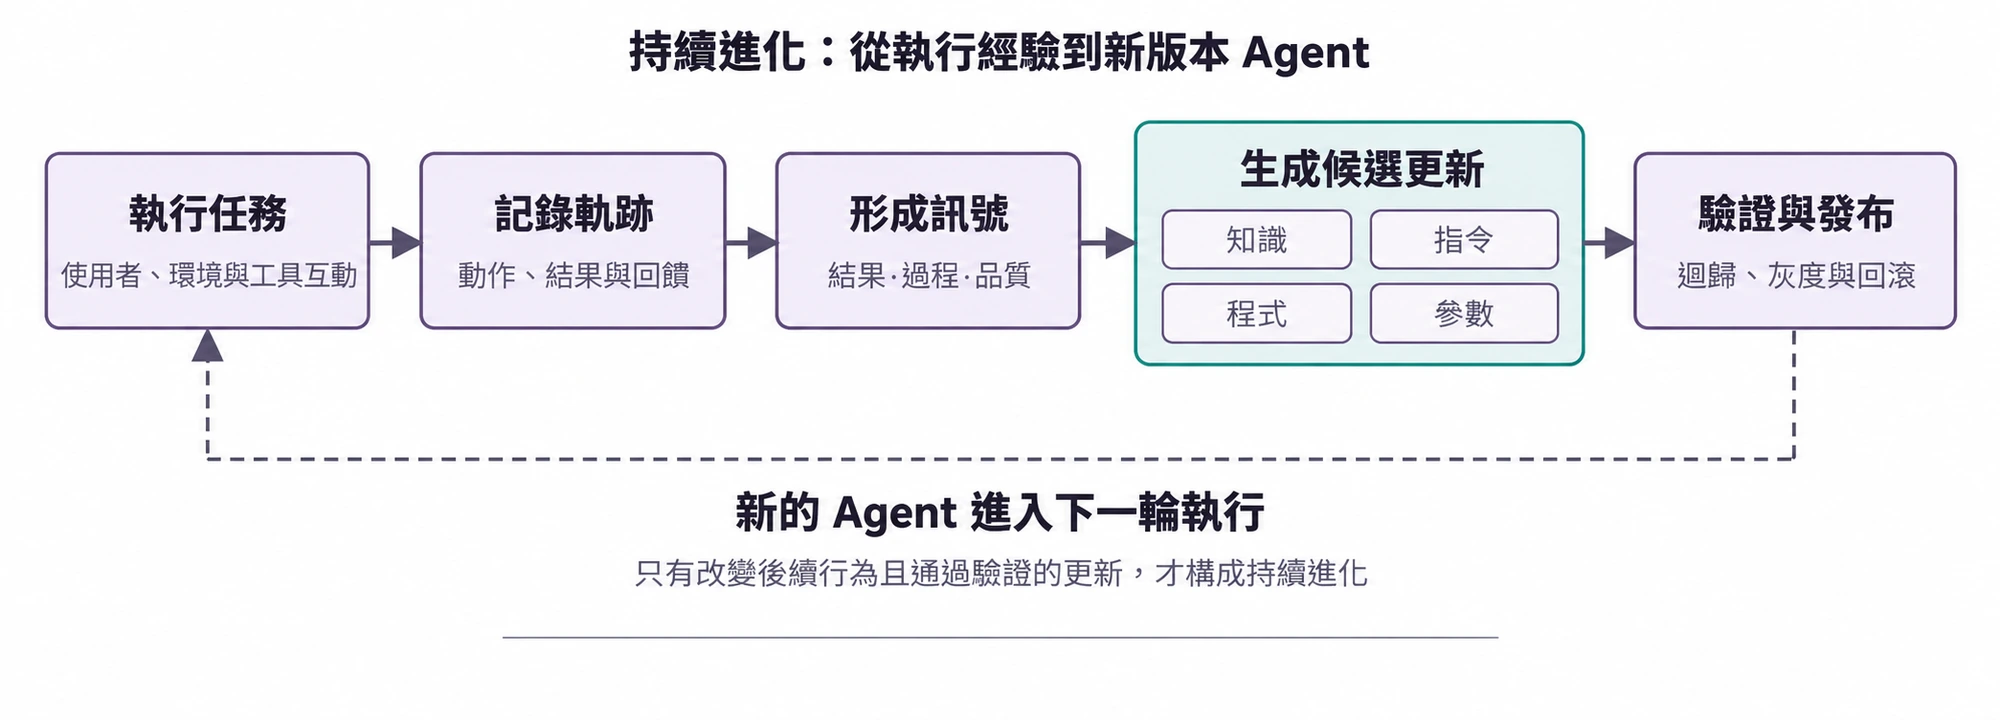
持續進化必須以可追溯的執行經驗為基礎,能夠改變後續行為,並經過驗證,確保沒有造成明顯退化。本章首先討論如何判斷一次執行究竟好在哪裡、錯在哪裡;然後比較四種更新方法及其適用邊界;接下來討論這些更新如何在長期執行中被驗證、發布、修訂與淘汰。
9.1從執行軌跡中獲得學習訊號
持續進化的起點是第七章所述的評估(evaluation)。如果系統不知道任務是否完成,也不知道哪一步造成了成功或失敗,那麼語言模型生成的反思只能是一種猜測。
評價一條軌跡,實質上是依次回答三個問題:事情是否辦成了,是否以允許的方式辦成,是否讓使用者舒服。圖9-2 將它們組織為三層驗證結構。
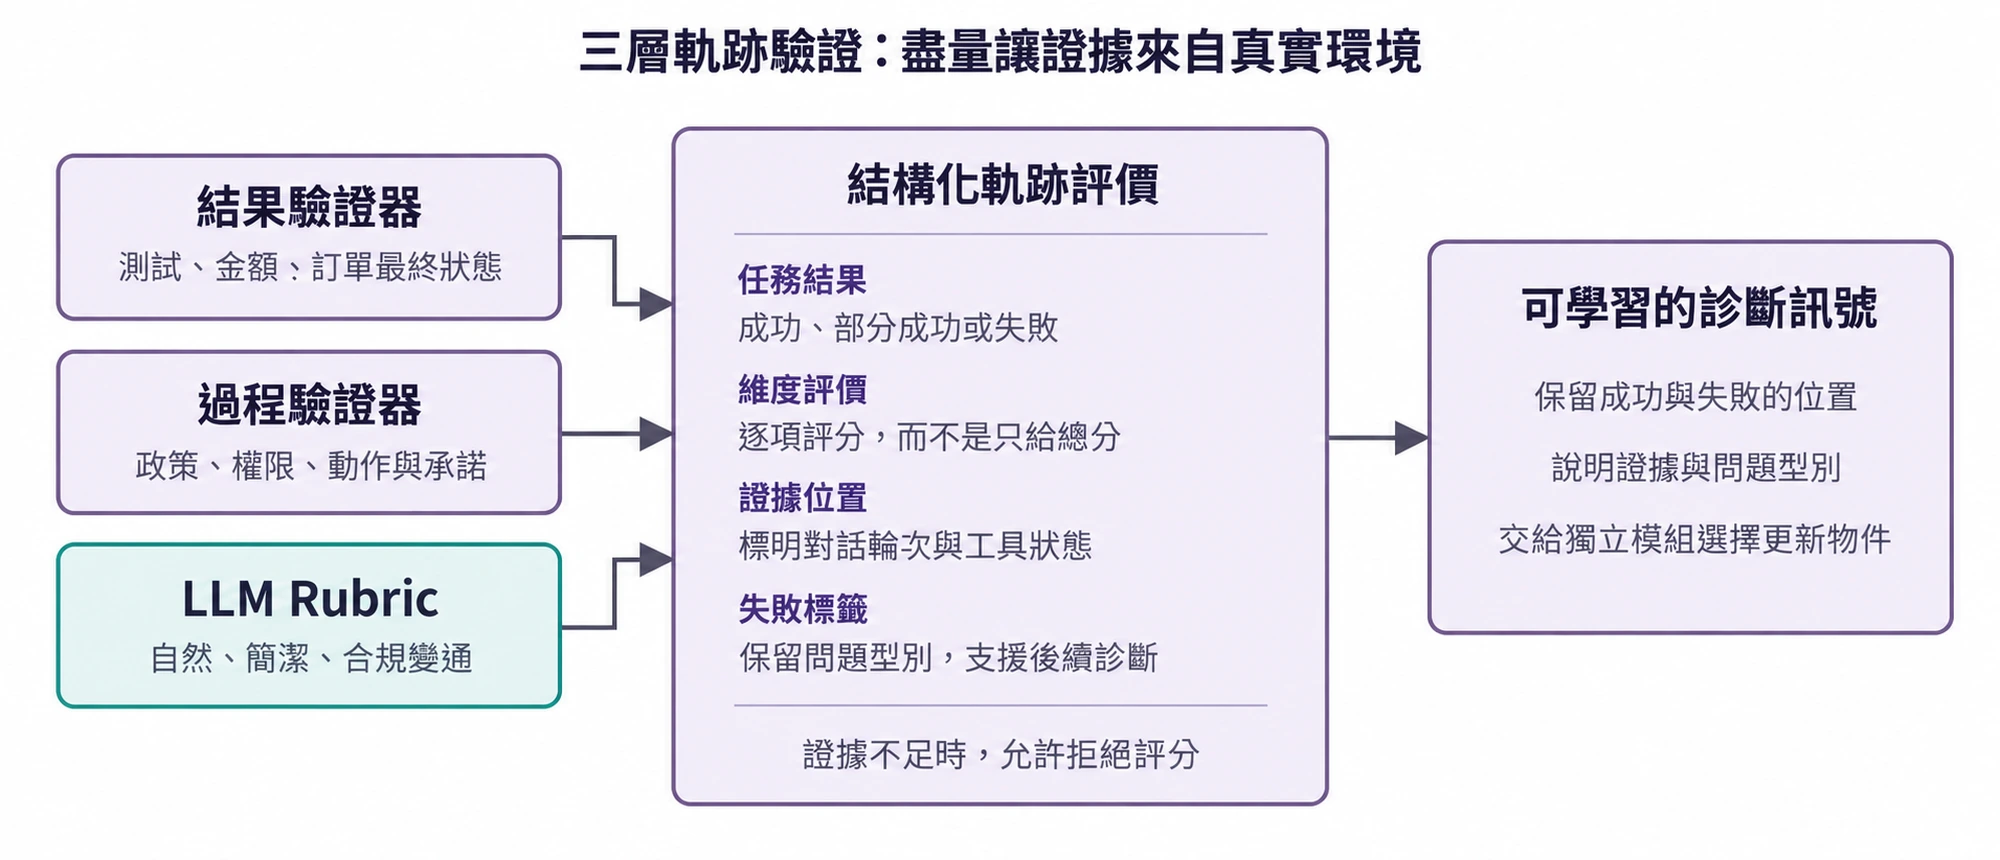
底層的結果驗證器回答「事情是否真的辦成」。 它讀取測試結果、資料庫狀態和工具返回:Coding Agent 可以執行測試、型別檢查和效能基準;替使用者辦理退款的 Agent 可以查詢訂單狀態和實際退款金額。這類訊號來自環境中的真實狀態,通常比模型對自己行為的描述可靠,因此是三層中最應優先建立的一層。
中間的過程驗證器回答「是否以允許的方式辦成」。 結果正確並不代表過程正確:刪除失敗的測試案例也能讓測試通過,口頭承諾使用者 「我們會在 7 天內退款,請耐心等候」 也可能得到暫時的滿意回饋。這一層檢查業務規則、權限和動作序列,用以區分「結果已經達成」與「結果以允許的路徑達成」。政策庫、權限表與動作軌跡均可精確表達,因此這一層同樣可以由程式碼判定。
上層的品質驗證器回答「是否讓使用者舒服」。 例如,客服是否耐心、是否提供了合規範圍內的變通方案,研究報告是否抓住了關鍵證據,生成文字是否自然簡潔。這些維度不影響事情辦成與否,但對使用者體驗是有影響的。此時可以使用第七章介紹的 LLM-as-a-Judge,預先定義評價量表(Rubric),要求驗證器逐項給分並引用軌跡證據。
以客服 Agent 為例,表9-1 將這三層展開為七個可逐項評分的維度:任務結果屬於結果層;規則遵從、隱私邊界與承諾—行動一致性屬於過程層;表達品質與合規變通屬於品質層;事實可靠性橫跨兩層,可與工具返回逐一比對的部分由程式碼核驗,其餘交由 Rubric 判斷。
表9-1 客服 Agent 的軌跡評價維度
| 維度 | 驗證問題 | 主要證據 |
|---|---|---|
| 任務結果 | 使用者的核心訴求是否得到解決 | 最終環境狀態、工具結果 |
| 規則遵從 | 是否違反政策、權限或必要流程 | 政策庫、動作軌跡 |
| 隱私邊界 | 是否洩露不應提供的資訊 | 回覆文字、資料存取記錄 |
| 事實可靠性 | 陳述是否有知識或工具結果支援 | 引用來源、工具返回 |
| 承諾—行動一致性 | 聲稱完成的操作是否真實發生 | 回覆與工具日誌對照 |
| 表達品質 | 是否自然、簡潔,避免重複與範本化 | 對話全文、語言 Rubric |
| 合規變通 | 原方案不可行時,是否找到允許的替代路徑 | 使用者目標、政策與後續動作 |
驗證器的輸出形態決定了它能否成為「學習訊號」。 單一總分只能反映一次執行的優劣,無法指出應當修改之處。可供後續學習的評價至少應包含四項內容:任務是成功、部分成功還是失敗;每個維度各自的結論;每條結論對應的證據位置(哪一輪對話、哪一次工具呼叫);以及失敗的型別標籤。驗證器還應被允許在證據不足時拒絕評分。與其把低置信度的結論當作事實固化下來,不如將該案例排除在學習集之外。具備這四項內容,下一節討論的四種更新方法才能判斷應當更新知識、提示詞、程式還是模型參數。
實驗 9-1 ★★:為客服 Agent 建構軌跡驗證器
實驗目的:把客服 Agent 的執行軌跡轉換成帶證據的結構化診斷,為後續的經驗提煉提供可靠學習訊號。
實驗說明:對照「只輸出一個總分」和「逐維度輸出結論、證據與置信度」兩種驗證方式,觀察哪一種更容易區分任務失敗、規則違規、虛假承諾和表達問題。持續進化不能只依賴成功率或單一分數。只有保留「哪裡錯、為什麼錯、證據在哪裡」,後續模組才知道應該更新知識、Prompt、程式還是模型參數;低置信度案例也不應自動進入學習集。
9.2Agent 持續進化的四種方法
學習訊號說明 Agent 應當改變,但沒有說明改變應發生在哪裡。事實和經驗適合寫成知識文件;可以用語言清楚表達的策略適合寫入提示詞或 Skill;可以精確執行的流程與約束適合寫成程式;感知、語言風格和隱含策略等高維能力則必須進入模型參數。圖9-3展示了這四種方式及其關係。
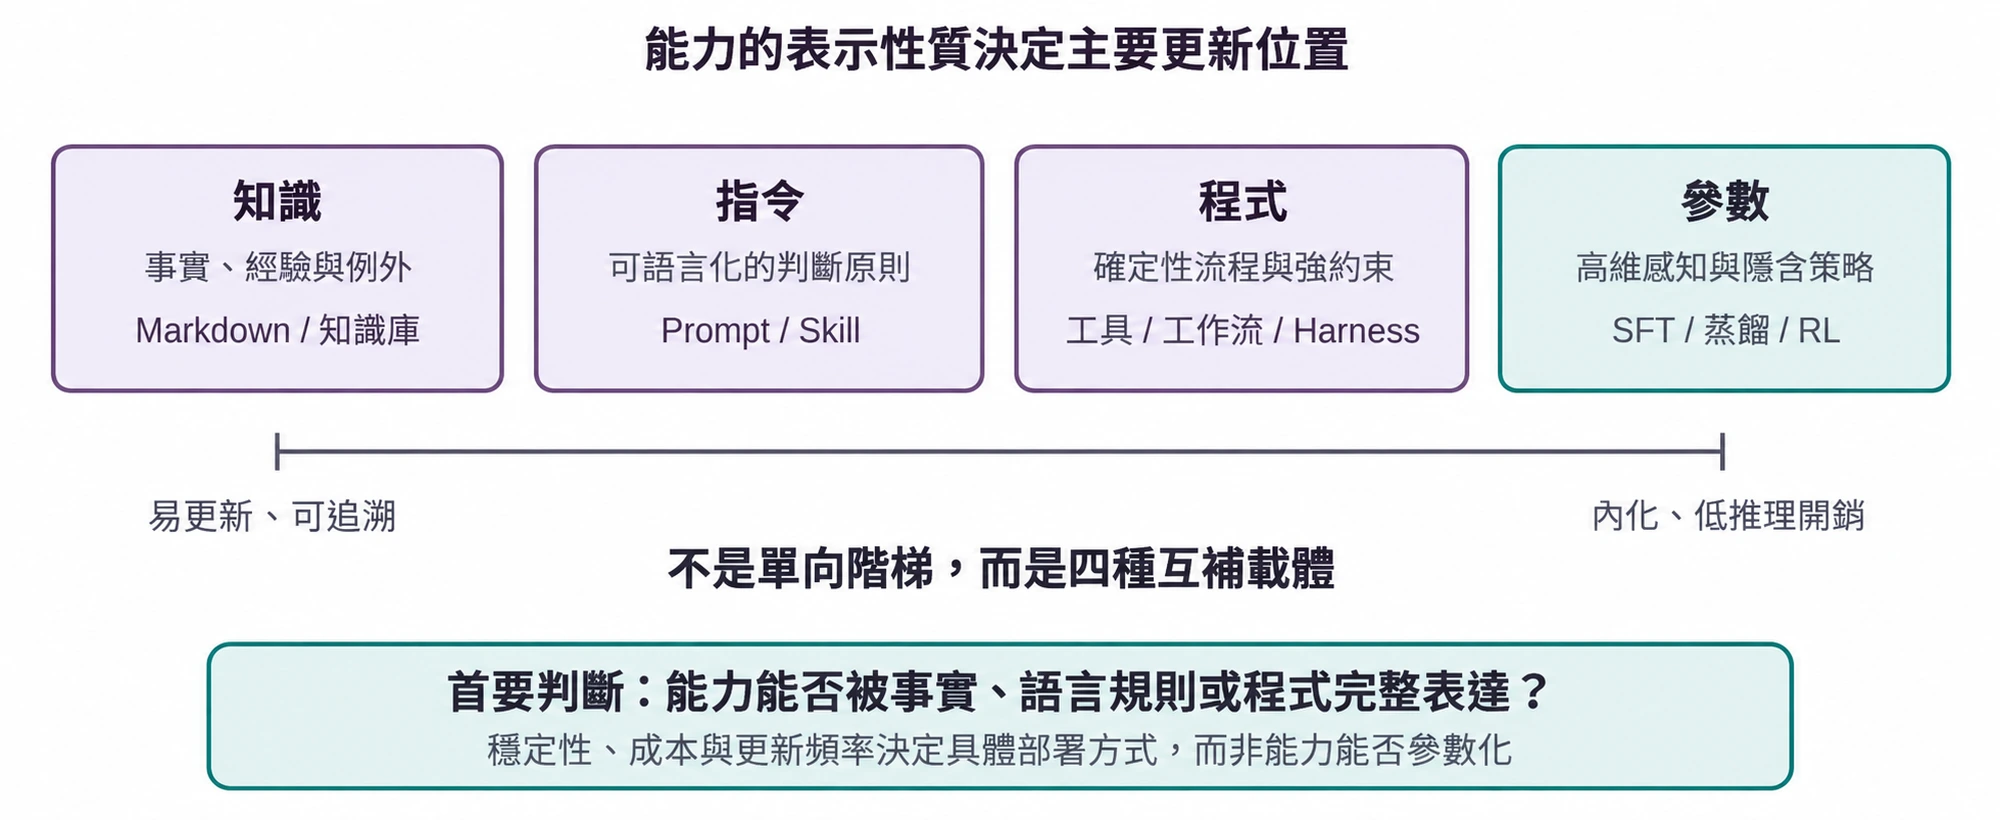
表9-2給出了一個緊湊的比較。四種方式並不互斥:醫療影像 Agent 依靠參數識別病灶,用知識庫提供最新指南,再用程式碼計算風險指標;客服模型的自然語氣來自後訓練,具體企業政策由知識和 Skill 提供,關鍵合規則由伺服器端程式碼兜底。
表9-2 四種持續進化方式的適用邊界
| 更新方式 | 適合承載 | 主要優勢 | 主要局限 |
|---|---|---|---|
| 經驗知識庫 | 事實、經驗規律、例外與來源 | 更新快、可追溯、可按需檢索 | 依賴檢索和模型正確應用 |
| Prompt 與 Skill | 需要理解語境、例外和優先順序,但仍能用自然語言說明的判斷原則 | 可解釋、作用範圍可控 | 容易膨脹、衝突或被忽略 |
| 程式與 Harness | 可確定解析、可執行驗證和高風險硬約束 | 可測試、執行穩定、成本低 | 開發與維護成本較高 |
| 模型參數 | 高維感知、生成風格和隱含策略 | 泛化能力強、推理開銷低 | 更新與迴歸成本高 |
同一能力可以拆到多個載體:事實進入知識庫,解釋例外的原則進入 Skill,不可繞過的權限仍由程式門控,高維識別能力再進入參數。路由結果只是更新提案,尚未獲得發布資格。
9.2.1將經驗沉澱為知識
最輕量的進化方式,是把多次執行中反覆出現的經驗整理成可檢索的知識文件。這裡所說的「經驗知識庫」與第三章共享儲存、索引和檢索技術,但知識來源和驗證目標不同。第三章主要從使用者對話、文件和資料集中擷取「使用者與世界是什麼樣的」;本章則從 Agent 的行動軌跡和結果中擷取「在什麼條件下應該怎樣做」。例如,「該航空公司要求特殊餐食提前二十四小時預訂」是領域知識;「訂票前先檢查特殊餐食截止時間,避免付款後才發現無法滿足需求」則是行動經驗。
原始軌跡不適合作為正式知識單元。它既長又嘈雜,包含工具原始輸出、偶然的繞路和環境細節。更穩妥的系統保留三層資料:不可變的原始軌跡用於稽核,單次執行分析記錄本次成敗與經驗草案,再對多條同類軌跡進行比較、聚類和歸納,形成面向未來的 Markdown 知識文件。正式文件通常寫清適用場景、推薦策略、禁止做法、例外條件、證據來源和最近驗證時間,而不是複述某一次任務的完整過程。
這種設計與第三章的 User as Code 採用了相同的兩階段思路。User as Code 先把對話事實追加到不可變日誌,再週期性重建結構化使用者模型;經驗學習同樣應先儲存證據,再離線生成可變知識。圖9-4展示了這一過程。把記錄與整理分開,可以避免一次偶發成功或網路故障立即改變 Agent,也使系統能夠在看到多條成功和失敗後再判斷共性。
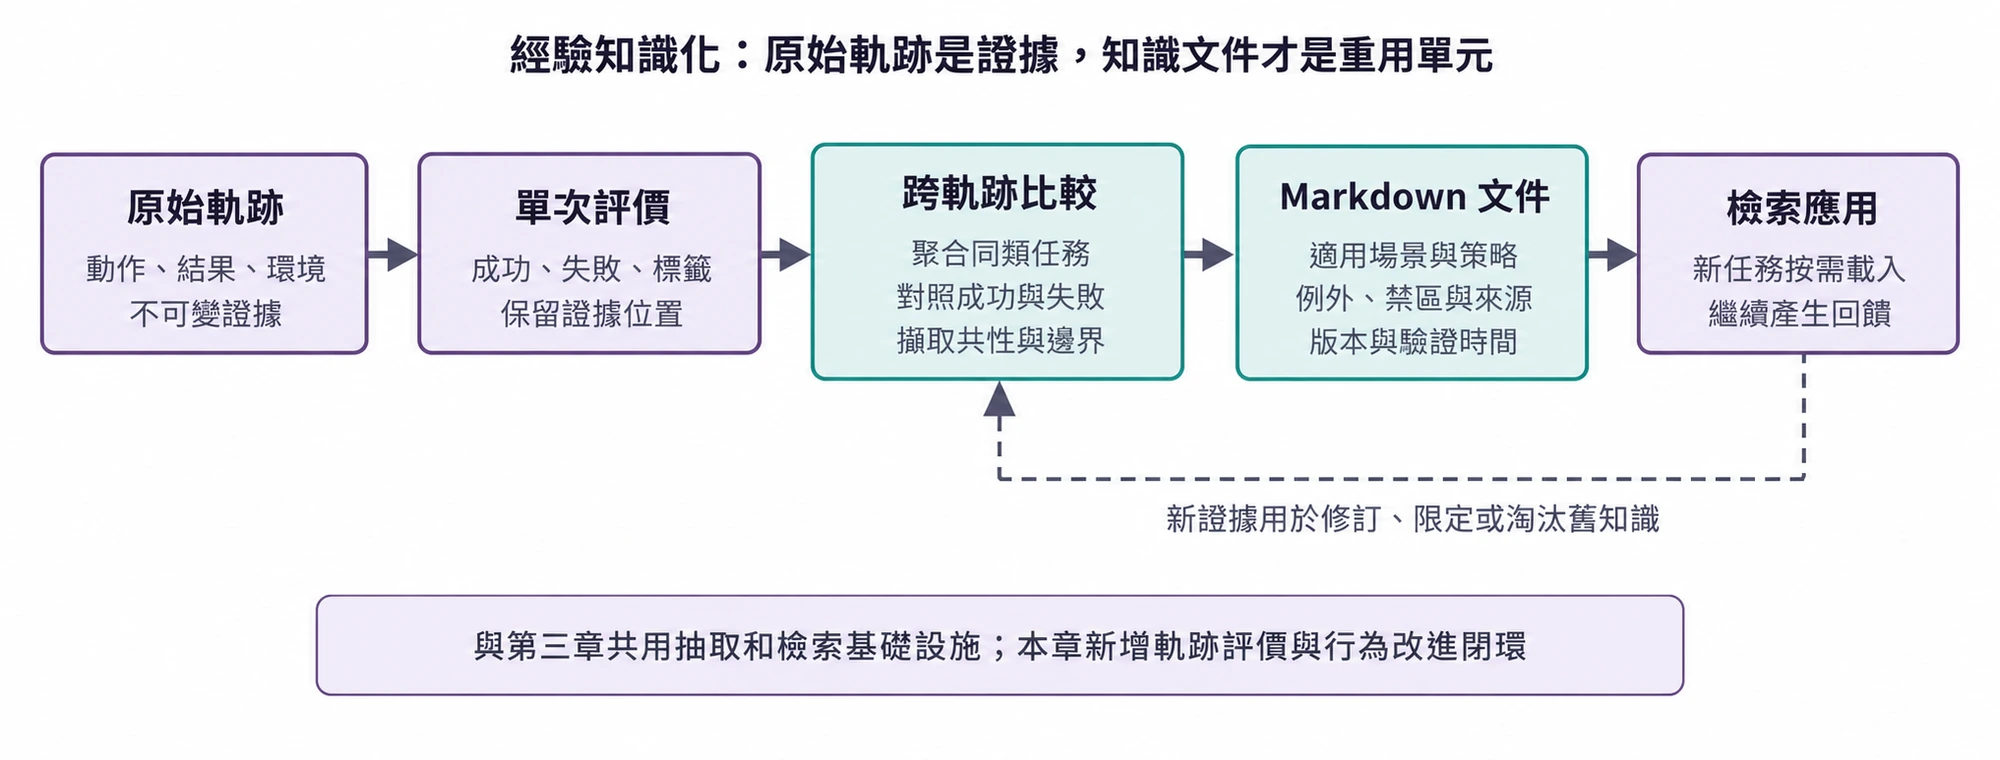
經驗文件不是簡單的軌跡摘要。真正有遷移價值的內容來自對照:同類成功軌跡做了什麼,失敗軌跡缺少什麼;某種策略在哪些環境版本中有效,在哪些前置條件下失效。第三章已經介紹知識抽取、聚類與檢索,本章不再重複這些演算法,而把重點放在軌跡評價如何成為抽取條件,以及抽取出的知識是否能提高後續任務表現。
一個完整的知識提煉管道可以分成五步。首先儲存不可變軌跡和環境結果;然後為單次執行生成結構化分析,列出任務型別、所需能力、觀察到的策略、錯誤與例外;接著按任務族聚合同類執行,為每條經驗草案建立「哪些軌跡支援、哪些軌跡反駁」的證據表;只有達到支援門檻的草案才寫入正式文件;最後在未參與提煉的新任務上測試遷移效果。
GAIA 經驗學習提供了一個直觀例子。GAIA[1] 包含需要綜合搜尋、網頁閱讀、檔案處理和計算的多步驟問題,AWorld[2] 則提供執行 Agent、呼叫這些工具和儲存軌跡的執行環境;前者像試卷,後者像考場與實驗記錄系統。舊式做法是在一次任務成功後立刻生成策略摘要並向量化入庫;更嚴格的實作會先用 GAIA 答案驗證或其他環境驗證器標記成功、部分成功和失敗,再比較同一任務族的多條路徑。成功軌跡貢獻策略草案,失敗軌跡貢獻排除性知識,部分成功軌跡則幫助識別「哪一段有效、哪一段仍有問題」。Reflexion[3] 所提出的自然語言反思可以參與生成經驗草案,但反思本身不是證據;只有與環境結果相符、得到跨軌跡支援並在新任務上顯示正向遷移的內容,才應進入正式經驗文件。
9.2.2將經驗寫成指令
經驗知識庫給 Agent 提供「可以參考的資料」,Prompt 和 Skill 則規定「應該怎樣行動」。當多條相似軌跡反覆暴露同一種策略錯誤,而且錯誤能夠用語言清楚描述時,才值得把經驗提升為指令。這裡先把三個概念分開:系統 Prompt 對所有任務生效,Skill 只在匹配到某個領域或工具時按需載入,程式/Harness 負責權限和其他硬約束。
Andrej Karpathy 將這種做法稱為系統提示學習(System Prompt Learning)[4]:模型遇到問題後,用一句清楚的話提醒未來的自己。DSPy[5] 在開發集上搜尋指令和示例;OPRO[6] 根據歷史提示詞及其得分提出提示提案;GEPA[7] 從失敗軌跡的自然語言反思中生成並篩選提示提案。這些方法適合離線批次最佳化;生產環境更適合使用可稽核的最小更新提案,並保留快速回滾路徑。
系統提示學習與第二章的提示工程不是一回事。第二章討論怎樣組織一份好 Prompt;本節討論什麼回饋足以觸發修改,以及更新提案怎樣安全發布。修改應是帶來源的最小 diff,而不是讓模型每次都重寫整份 Prompt——這正是第一章命名的最小 diff + 可回滾模式。待驗證版本必須同時在觸發失敗的邊界集和正常工作的保留集上測試,前者要改善,後者不能退化。
例子一:轉接邊界的規則化
τ²-bench 的 telecom 政策中,關於轉接人工只有兩條原則性規定:請求超出 Agent 的動作範圍時才轉接,轉接前應先盡力解決。第七章解剖該環境時,這兩條並未顯出問題;換用能力較弱的模型執行,缺陷隨即暴露——工具返回錯誤後 Agent 反覆重試,最終以轉接人工收場,提煉集的 20 條任務中有 19 條如此結束。
將這 19 條失敗軌跡交由模型自行歸納,產出若干條可執行的規則追加到政策末尾,再在一批未參與提煉的任務上重新執行:通過率由 12.3% 升至 19.3%,且原本通過的任務無一被改壞。
提煉所依據的材料決定了能夠歸納出什麼。 同樣是這 19 條軌跡,僅提供失敗摘要與錯誤文字時,模型歸納出的是「同一工具反覆報錯即不應繼續呼叫」;補充 Agent 與使用者各自可呼叫的工具清單之後,歸納結果變為「網路狀態、SIM 卡、APN 等項屬於使用者裝置側,應引導使用者自行操作而非直接呼叫」。前者記錄的是教訓,後者理解的是職責歸屬。
模型會把觀察到的行為當作應然的行為。 第一版規則中有兩條為「連續三次呼叫失敗即轉接人工」「使用者兩次未提供號碼即轉接人工」——軌跡中出現最頻繁的正是轉接人工,模型據此將其視為合理的兜底手段。但在這套評估中轉接人工必然判定失敗,這兩條規則等於把失敗寫入了規範。提煉產物因此不能直接發布,須經與提煉者相互獨立的驗證。
被修復的往往是極樸素的缺陷。 基線中有一條典型軌跡:Agent 需要使用者的電話號碼,於是呼叫查詢工具,並將「請您提供您的電話號碼」填入參數,連續五次,五次報錯,隨後轉接人工。它已經判斷出應當詢問使用者,卻把這句話說給了工具。規則生效後,它先在對話中提出請求,取得號碼再行查詢;此後欲檢查 SIM 卡狀態遭工具拒絕,轉而引導使用者自行重新插拔 SIM 卡,任務通過。
實驗 9-2 ★★:從 τ²-bench 失敗軌跡提煉轉接與工具使用規則
沿用第七章的 τ²-bench telecom 環境。提煉集與遷移集在上游倉庫中本就是兩套互不相交的任務,提煉過程接觸不到遷移集。
先以弱模型執行提煉集並儲存失敗軌跡;規則由模型歸納而非人工撰寫,生成後追加至原始政策末尾;再在遷移集上對照原始策略與兩個進化版本。三臂之間只替換策略檔案,使用者模擬器保持不變。
除通過率外,還需記錄三項與規則直接對應的行為指標:轉接人工的比例、Agent 越界呼叫使用者側工具的次數、參數缺失即發出的呼叫次數。後兩項在進化版本中均下降約八成,說明通過率的提升來自規則修復了具體動作。
同樣的做法可以移植到其他領域。航空客服 Agent 的典型問題案例是:使用者對退票費、改簽費或行李政策提出異議,Agent 未查詢政策、未解釋規則、未尋找合規的替代方案,即呼叫 transfer_to_human。一般的政策爭議無須轉接,只有使用者明確要求人工介入,或出現安全相關情形時才必須轉接。診斷同樣指向轉接邊界未予明確,修法同樣是將其落成一條帶出處的最小規則。
實驗 9-3 ★★:基於失敗軌跡最佳化航空客服的系統 Prompt
實驗目的:讓航空客服 Agent 修復「遇到普通政策爭議就過早轉人工」的行為,同時保留明確要求人工和安全事件的轉接能力。
實驗說明:從失敗軌跡中擷取規則遵從、任務解決和合規變通三個維度,生成一條帶來源的最小 Prompt 補丁,再與初始版本、人工調優版本在相同條件下對照。更新提案只有在邊界案例改善、舊任務不退化並通過發布門檻後,才進入灰度階段。
實驗說明了什麼:Prompt 自動最佳化的重點不是讓模型自由改寫一大段文字,而是把可歸因的失敗轉成作用域明確、可回滾、可驗證的局部規則。
例子二:需求澄清 Skill——從「直接開工」到「先確認再執行」
第二章介紹了如何編寫一份 Skill。這裡假設系統已經有一份初版的需求澄清 Skill,關注的是另一件事:當 Agent 在生產環境中不斷收到使用者回饋時,如何自動判斷「什麼時候應該先問,問什麼,什麼時候可以直接開始」是否需要更新。
這是一個典型的流程性問題。使用者說「把登入頁改成支援企業登入」,Agent 如果立刻開工,可能在身分提供商、回退方式、相容舊使用者和上線範圍上替使用者作出其尚未考慮過的選擇;如果無論任務大小都先列十幾個問題,又會把簡單修改變成一次訪談。問得太少會導致返工,問得太多會增加打擾。 Skill 要表達的不是「所有任務都必須確認」,而是一條帶作用域的判斷路徑。
一個初版流程可以這樣寫:先判斷任務的歧義程度、風險和返工成本;低風險、容易撤銷的小改動,說明假設後直接執行;涉及架構、資料、權限、公開介面或大範圍改動時,集中提出少量真正會改變方案的問題;得到答案後生成短 Spec 或 Plan,列出目標、非目標、關鍵取捨、假設和驗收標準,交給使用者確認;確認後再執行,過程中發現原 Spec 不成立時暫停並重新確認。
持續進化從執行證據開始。系統應同時記錄任務、澄清問題、Spec 版本、使用者修改、執行結果和交付後的返工。負回饋可能是「做出來的和我想像的不一樣」,也可能是「你問得太多了」;正回饋則包括使用者一次確認後順利交付、主動修改 Spec 後減少返工,以及在低風險任務中沒有被多餘問題打斷。單獨儲存一句抱怨不足以觸發更新,必須把回饋和具體軌跡、任務型別以及結果關聯起來。
當多條軌跡反覆指向同一個缺口時,Agent 可以提出最小 Skill 更新提案。例如,多個涉及認證架構的任務都在交付後才發現需要相容舊登入方式,規則草案可以要求在執行前確認「身分提供商、回退路徑和相容範圍」;如果大量拼寫修復都被 Agent 先問一輪,規則草案則應收窄高風險與高歧義的觸發範圍。
這套流程需要透過對照實驗驗證。可以比較「直接執行」「先提問再執行」和「提問後生成 Spec、確認後執行」三種策略,並按任務複雜度分層。評價指標至少包括需求偏差率、交付後的返工次數、澄清輪數、首次有效產出時間、使用者放棄率、Spec 被修改的比例和高風險操作錯誤率。更新提案只有在減少需求偏差的同時沒有顯著增加打擾,並在未參與提煉的任務上通過迴歸,才進入灰度發布。
這個例子還說明了 Skill 與 Harness 的邊界。Skill 負責理解語境並主動提出問題、整理 Spec 和說明取捨;Harness 負責在缺少確認時否決高風險寫入、直接操作 main 或繞過發布流程。Harness 中的否決器不能替模型決定 PR 應該怎樣描述,也不能代替模型選擇需求方案。隨著經驗積累,穩定的對話軌跡還可以進一步生成第八章所需的 SFT 或 RL 訓練資料。
實驗 9-4 ★★:從使用者回饋中進化需求澄清與 Spec 確認 Skill
實驗目的:檢驗 Agent 能否在「需求偏差」和「互動打擾」之間找到更好的澄清策略,並把經過驗證的改進寫回 Skill。
實驗說明:準備一組低風險、低歧義任務和一組涉及架構、權限、資料或公開介面的高風險任務,比較直接執行、提問後執行、提問後 Spec 確認三種流程。記錄使用者回答、Spec 修改、交付結果和返工回饋,讓 Agent 生成 Skill 更新提案;提案必須經過留出任務迴歸、打擾成本檢查和高風險否決器驗證。
實驗說明了什麼:持續進化不是把每次抱怨直接追加到 Prompt,而是從結果和回饋中識別作用域,提出最小指令更新,再用獨立評價器決定是否發布。
9.2.3將經驗寫成程式
當經驗描述的是穩定、重複且可驗證的操作時,每次都讓模型重新閱讀文件和推理並不經濟。此時更合適的做法是把經驗編譯為工作流、工具或 Harness 程式碼,使一次探索變成可重複執行的程式。第五章已經說明 Coding Agent 如何讀寫檔案、執行測試和生成系統;本節關注的不是一般程式碼生成,而是 Agent 如何根據自己的軌跡修改未來版本的自己。
可修改的物件遠不止新工具。操作層可以把瀏覽器軌跡編譯為參數化工作流,或為變化的 API 生成介面卡;控制層可以修改工具路由、重試、熔斷和上下文壓縮策略;驗證層可以根據生產失敗新增參數檢查、狀態驗證器和迴歸測試;架構層則可以增加 Reviewer Agent,改變規劃與執行之間的資訊流。
瀏覽器工作流說明了程式化經驗的價值。它可以類比電子表格的巨集錄製:第一次傳送郵件時,多模態 Agent 透過觀察—思考—行動尋找 「撰寫、收件人、主題、正文、傳送」 這些控制元件;以後傳送另一封郵件時,流程沒有變化,只有收件人和內容不同,沒必要再次呼叫模型從畫素和 DOM 中重新發現整條路徑。系統要做的,是把第一次探索產生的軌跡編譯成一個帶參數、狀態檢查和版本資訊的小程式。
圖9-4所示的知識提煉過程在瀏覽器場景中對應一個更具體的生命週期:
- 捕獲軌跡:記錄導航、點選、輸入、下拉選擇等動作,儲存動作參數、當時的 URL,以及 XPath、CSS 等元素定位證據。定位資訊只用於再次尋找元素,不能證明任務已經完成。
- 參數化:把首次執行中的字面量識別為範本變數,例如將
test@example.com、郵件主題和正文替換為{recipient}、{subject}和{content};其餘穩定動作保持不變。 - 定義狀態檢查:為動作增加執行前檢查和執行後檢查,例如 「傳送按鈕目前可見」;為整個工作流增加最終狀態檢查。動作執行成功與任務成功是兩件事,最終狀態檢查必須讀取真實頁面或後端狀態。
- 獨立回放驗證:系統必須把沙箱帳號或測試站點重置到獨立初始狀態,再完整回放錄製下來的程式;每一步的執行前檢查、執行後檢查和最終狀態檢查全部通過後,才能發布。
- 匹配與回放:新任務到來時,先在正式能力庫中按意圖和關鍵字尋找工作流,擷取本次參數,然後由 Playwright 直接執行。回放路徑不需要逐步呼叫 LLM,但仍需等待元素可用並完成所有狀態檢查。
- 失效與重學:找不到目標元素、狀態檢查不通過、API Schema 改變或最終狀態錯誤時,回退到完整的 Agent 模式重新探索。
PreAct[8] 的實驗中,這類程式在重複任務上實現了 8.5–13 倍的端到端加速,回放階段不需要逐步呼叫語言模型;更重要的結論是,流程記憶必須同時具備動作前驗證、動作後驗證和獨立回放驗證。否則系統很容易得到一種危險的假象:每個按鈕都點過了,但某個欄位其實為空,任務從未真正完成。
實驗 9-5 ★★★:從瀏覽器軌跡生成可驗證工作流
實驗目的:驗證網頁 Agent 能否把一次探索轉化為可重用工作流,並在頁面變化或狀態異常時拒絕錯誤回放。
實驗說明:把一次成功軌跡編譯成帶參數和狀態檢查的待驗證工作流,與「每次都重新探索」的基線比較;再改變頁面或製造假成功,觀察待驗證工作流是否失效並回退到完整 Agent。
實驗說明了什麼:流程記憶的價值不在於重複執行動作,而在於確保任務的最終狀態仍然正確。可重用工作流必須有獨立驗證和失效機制,否則加速只是把錯誤更快地重複。
Agent 修改自己的程式碼不意味著執行中的行程直接覆寫自身。生產系統應從目前穩定版本建立隔離更新分支,由 Coding Agent 生成最小補丁,依次通過靜態檢查、單元測試、安全掃描、失敗軌跡重放和舊任務迴歸,再生成可灰度部署的新版本。這把「自我修改」轉化為可稽核的軟體發布流程,也正是第九章與第五章的邊界:第五章提供修改系統的能力,本章提供由經驗觸發、以驗證閉環約束的自我修改方法。
Git worktree 和 Pull Request 是軟體開發流程中一個很好的例子。Skill 應主動指導 Agent:先為任務建立獨立 worktree,確認需求和 Spec,完成實作與測試,提交有意義的 commit,並在 Pull Request 中寫清背景、方案、測試結果和剩餘風險。Harness 不負責替模型做這些判斷,但可以在它準備結束任務時檢查是否仍在 main 上直接提交、是否遺漏 worktree 或 Pull Request;一旦違反邊界就否決這次操作,要求 Agent 返回修復。
僅有「補丁盡量小」還不足以支援可靠歸因。每個修改請求還應是一份可證偽的變更契約:列出失敗證據、推斷根因、歸屬的 Harness 元件、修改提案、預期修復的行為、可能受損的既有行為,以及分別驗證兩者的測試案例。Agentic Harness Engineering 將這種做法概括為元件、經驗和決策三層可觀測性:可編輯元件都有檔案級表示;海量軌跡先整理為可逐層下鑽的證據;每次編輯在執行前宣告影響預測,再由下一輪結果驗證[9]。這樣,分數上漲才能與某個具體機制建立聯繫,而不只是一次不可解釋的試錯。
提案生成器的輸入也不應只有失敗案例。Self-Harness 的做法還會提供必須保留的成功行為和此前被拒絕的修改記錄[10]。前者告訴 Agent 哪些性質不能在修復時被破壞,後者避免它換一種說法重複提交已經失敗的方案。失敗證據、成功約束與歷史嘗試共同構成一個有邊界的方案空間,比把全部原始碼和原始日誌無差別塞給修改 Agent 更容易產生局部、可驗證的改動。
工具創造也遵循同一個協定。Alita[11] 給出的案例是:Agent 要從一段由《魔戒》中咕嚕配音演員解說的 YouTube 360 VR 影片中,找出恐龍首次出現後緊接著提到的數字。它發現自己缺少字幕讀取能力後,搜尋並測試 youtube-transcript-api,將其封裝為新的字幕工具,最終從字幕中得到答案 100000000。只有安全掃描、功能測試和後續任務重用都通過,新工具才進入能力庫。
實驗 9-6 ★★★:由失敗軌跡觸發 Agent 自我修改
實驗目的:檢驗系統能否把「不可重試錯誤被反覆呼叫」的經驗寫入重試與熔斷程式,同時保留臨時故障的恢復能力。
實驗說明:比較「只在 Prompt 中提醒不要重試」和「修改程式中的重試策略」兩種修復。修改提案必須經過失敗軌跡重放、正常故障迴歸和安全發布門檻,且不能修改驗證器或穩定版本。
實驗說明了什麼:能夠確定性執行的約束應該進入程式,而不是繼續堆在 Prompt 裡。Agent 可以提出程式碼提案,但「是否能發布」必須由模型外的測試、稽核和回滾機制決定。
驗證層也可以採用同一協定:當多條使用者糾正、點踩或事後稽核都指向「高風險操作未經確認」時,系統生成一個確認門禁提案。提案必須在邊界任務和正常任務上都通過驗證,且安全門本身不能被提案修改。這與第一章三層護欄裡資料層的道理相同:真正的保證必須來自被修改者無法觸及的那一層。
實驗 9-7 ★★:由使用者回饋觸發高風險操作確認門禁
實驗目的:檢驗系統能否從使用者糾正和事後稽核中發現安全流程缺口,並為高風險工具呼叫生成確認門禁。
實驗說明:用危險操作邊界集和正常操作保留集共同評價門禁提案。提案既要攔住未經確認的高風險呼叫,也不能阻斷正常任務;生成提案的 Agent 無權修改安全測試和批准規則。
實驗說明了什麼:安全能力的進化不能由修改者自證成功。真實模型生成的更新提案可能被安全門拒絕,這正說明獨立驗證器和不可修改的可信根比「提案看起來合理」更重要。
以動態組合實現自我進化
Cordis 論文指出,傳統意義上的組合是靜態的,函式呼叫、模組匯入和類繼承都在編譯期確定,執行期不再變化;而外掛系統和自進化 Harness 需要的是動態組合,元件要在執行中被裝入、卸下和重新設定[12]。Agent 的每一次自我修改,本質上都是一次動態組合。
論文把動態組合拆成兩個正交的維度。時間可組合性(temporal composability)問的是:一個元件被移除時,它對共享環境做過的修改能否被完整、安全地撤銷——這要求執行環境追蹤它的每一次資源分配、事件註冊和狀態變更。空間可組合性(spatial composability)問的是:元件之間能否以結構化、可驗證的方式宣告、發現和解析彼此的依賴,並在依賴變化時協調各自的生命週期。前者關心改了什麼,後者關心依賴什麼。
自進化 Harness 是這個問題最尖銳的場景。它帶來的困難在於,要撤銷的副作用是長期存活、帶狀態的;要解析的依賴會在執行中出現、消失或改變身分。由於缺少時間可組合性,每次自我修改都要整體重啟,丟掉行程內積累的全部狀態,進行中的任務被反覆打斷。由於缺少空間可組合性,每個模組只能用臨時手段自己察覺依賴的出現、消失和改變,而一次簡單的程式碼替換可能靜默地破壞依賴方,或者引入迴圈依賴。
Cordis 的思路是把兩個原本屬於編譯期的概念提升到執行期。效果系統本來用於推理 「計算如何修改環境」,被提升為可撤銷效果:每一次對上下文的變換都攜帶一個明確的逆操作,由執行環境追蹤,元件移除時上下文隨之恢復。協效果(coeffect)系統本來用於推理 「計算對環境有什麼要求」,被提升為反應式協效果:元件把自己需要的依賴宣告成一份規格,上下文每次變化都按這份規格通知它啟用、失活還是無關。論文進一步用一套動態組合演算,把這個性質從單個元件推廣到相互交錯的元件系統——可組合性必須是可傳遞的。
自我進化的上限,不取決於模型能寫出多好的程式碼,而取決於承載它的系統具有多強的可組合性。
可組合性解決了 「能不能安全地裝卸」,沒有解決 「該不該裝」。模型寫出的外掛不能被自動提升為正式外掛,要留下來必須另走前面說的 worktree 加 Pull Request 那條更慢的路。
最後,進化本身也有代價。執行中的外掛會改變模型可見的工具集和提示片段,請求前綴一變,第二章討論的 KV Cache 就從變化處開始失效。
9.2.4將經驗寫入參數
知識、指令和程式都建立在一個前提上:目標能力能夠被外部符號較完整地表達。醫療影像理解、自然的語音韻律、消除文字的範本化「AI 味」、長程規劃等能力卻很難壓縮成幾條規則或工作流。這類能力必須透過後訓練寫入模型參數。彎引號的作用域判斷處在中間地帶:文件語法邊界可以由程式解析,語境和例外需要 Skill 表達,跨任務的識別習慣才適合透過後訓練內化。
是否參數化並不由「任務是否長期穩定」單獨決定。新影像裝置帶來的域偏移仍可能需要 LoRA 或持續微調;快速變化的語言風格也可以透過週期性偏好訓練適應。穩定性影響的是更新頻率和成本,真正決定主要載體的是能力的表示性質。
第八章已經完整討論 SFT、蒸餾和 RL,本節不重複。對持續進化而言,關鍵是把經過評價的生產軌跡轉化為訓練資料:高品質示範可以進入 SFT,明確偏好可以形成成對資料,具有可靠環境獎勵的互動可以用於 RL。
9.2.5從更新產物到更新「更新方法」
前面的四種方法討論了經驗最終寫到哪裡,但持續進化還有另一條正交的軸:系統正在最佳化的究竟是某份產物的內容,還是產生、管理和驗證這些產物的方法。沿這條軸看,最佳化物件可以逐層擴大為:單條規則或記憶 → 結構化上下文 → 工作流 → Harness 程式碼 → 產生更新提案的最佳化器程式碼[13]。這不是五種新的更新載體,而是五種不同的搜尋尺度;知識、Prompt、Skill 和程式都可能出現在其中多個層級。
最內層只修改產物內容。例如,根據失敗軌跡給系統提示增加一條局部規則,或給經驗文件補充一個例外條件。這種修改作用面小,容易歸因和回滾,應當是預設選擇。不過,反覆讓模型重寫整份 Prompt 或記憶會產生另一類退化:為了追求簡潔,舊版本中的少數重要細節可能在多輪改寫後逐漸消失;相互制約的條件也可能被合併成一句過度抽象的原則。Agentic Context Engineering(ACE)把上下文維護成帶穩定識別符號的條目集合,由生成、反思和整理模組提出增量更新,再用確定性邏輯合併與去重,而不是每輪重寫一個越來越短的文字塊[14]。它為本章前文「最小 diff、保留來源」的原則提供了一個具體研究例項。
再向外一層,最佳化物件不再只是「上下文裡有什麼」,而是「上下文應怎樣被構造」。Meta Context Engineering(MCE)把兩者拆成內外兩個迴圈:內層在給定管理方法下最佳化目前任務的上下文產物,外層則根據多輪執行和驗證結果,修改搜尋、選擇、過濾、格式化這些上下文操作本身[15]。這一區分很重要:修改一條檢索規則是在改內容管理機制;讓系統比較多種檢索與整理機制、保留遷移效果更好的版本,才是在學習「如何管理上下文」。
同樣的思想可以擴展到工作流和整個 Harness。AFlow 把由多個 LLM 呼叫組成的工作流表示為程式碼圖,透過執行回饋搜尋節點與控制流的組合[16];Meta-Harness 則讓 Coding Agent 讀取待驗證 Harness 版本的原始碼、分數和軌跡,搜尋決定資訊如何儲存、檢索和呈現的程式碼[17]。第五章已經說明程式碼是 Agent 表達系統結構的通用語言;這裡的新增之處是:程式碼不只是一次生成的產物,還可以連同評估歷史一起成為持續搜尋的物件。
這類外層搜尋很快會遇到回饋成本問題。探索策略決定從哪個候選繼續、何時另開分支、並行投入多少 Worker,以及什麼時候停止;它的好壞往往要經過很長的生成—評估鏈條才能顯現。若每個候選策略都必須重新呼叫 Agent 和評估器,最佳化探索策略本身可能比完成任務更昂貴。
Dream-RSI 提出了一種不同於「總結歷史」的機制:把已經完成的發現過程儲存為發現樹,再把這棵樹當作經驗性的回放模擬器(replay simulator)[18]。根節點表示初始工作區;每個子節點儲存從某個歷史狀態繼續嘗試後得到的工作區快照、候選產物、評估診斷和分數。候選策略透過與線上探索相同的介面,逐步選擇要展開的葉節點或從根節點開啟新分支。回放器只揭示相應節點中已經記錄的結果,不必再次執行底層 Agent 和評估器。
回放成立的關鍵,是線上與離線階段使用相同的決策介面,並且只向策略逐步揭示目前已經展開的子樹。線上階段,被選中的節點會真正呼叫底層 Agent 和評估器;離線階段,相同選擇只返回歷史中已經記錄的後繼。候選策略因此可以比較不同的分支、順序、並行批次和停止時機,又不能偷看線上決策時尚不可見的未來結果。
這形成了三個階段的遞迴閉環:線上探索使用目前策略生成新的發現樹;構造回放世界把發現樹加入歷史模擬器池;離線做夢讓策略開發 Agent 修改探索策略程式碼,並按候選品質、執行成本和並行效率比較版本。入選策略重新上線後產生新的樹,也擴大下一輪可以回放的經驗範圍。候選集合保留目前策略,因此新版本至少不會在已有歷史的平均回放分數上更差,但這只是歷史內的保證。
這裡的「回放」與前文兩種歷史重用方式不同。軌跡總結把經驗壓縮成知識或 Prompt,改變的是 Agent 知道什麼;瀏覽器工作流回放讓程式在新任務中重複一條已驗證路徑,改變的是 Agent 怎樣重複執行;發現樹回放則比較 Agent 怎樣組織探索。它也不是能夠預測任意動作後果的完整世界模型,只能重組歷史中實際走過的分支,不能保證在舊樹上得分更高的策略能遷移到新任務。
從本章的分類看,歷史回放不是知識、Prompt、程式和參數之外的第五種更新載體,而是一種產生並驗證更新提案的新機制。Dream-RSI 最終修改的是探索策略程式碼,因此產物仍屬於程式/Harness;它的新意在於把過去作為上下文或訓練資料的歷史,變成可反覆互動的離線評估環境,把自我進化推進到「如何分配探索計算」的元策略層。
實驗 9-8 ★★★:把這本書交給 Hermes:它能升級自己嗎?
實驗目的:檢驗 Agent 能否閱讀外部知識、發現自身問題,並在外部審查和測試約束下完成一次自我更新。
實驗說明:不給 Agent 預設修復目標,而是觀察它能否把書中的原則對映到自己的程式碼,並根據 Reviewer 的退回意見繼續修正。穩定版本、驗收測試和批准門檻始終位於它的修改權限之外。
實驗說明了什麼:自我修改不是「模型讀完資料後直接改程式碼」,而是「理解原則 → 提出更新提案 → 接受外部檢驗 → 根據回饋修正」的閉環。一次提案被接受,只能證明更新流程成立,不能自動證明下游能力已經提升。
9.3建構可長期執行的持續進化閉環
四種更新方式只有進入同一個自主迴圈,才會從單次最佳化變成持續進化。圖9-5展示了生產系統中更穩妥的雙迴圈結構:線上執行迴圈只完成任務並記錄證據,不直接改寫正式 Agent;離線進化迴圈聚合軌跡、診斷根因、生成更新提案,再通過驗證門檻發布新版本。兩者透過版本化的經驗庫和評估集連接。
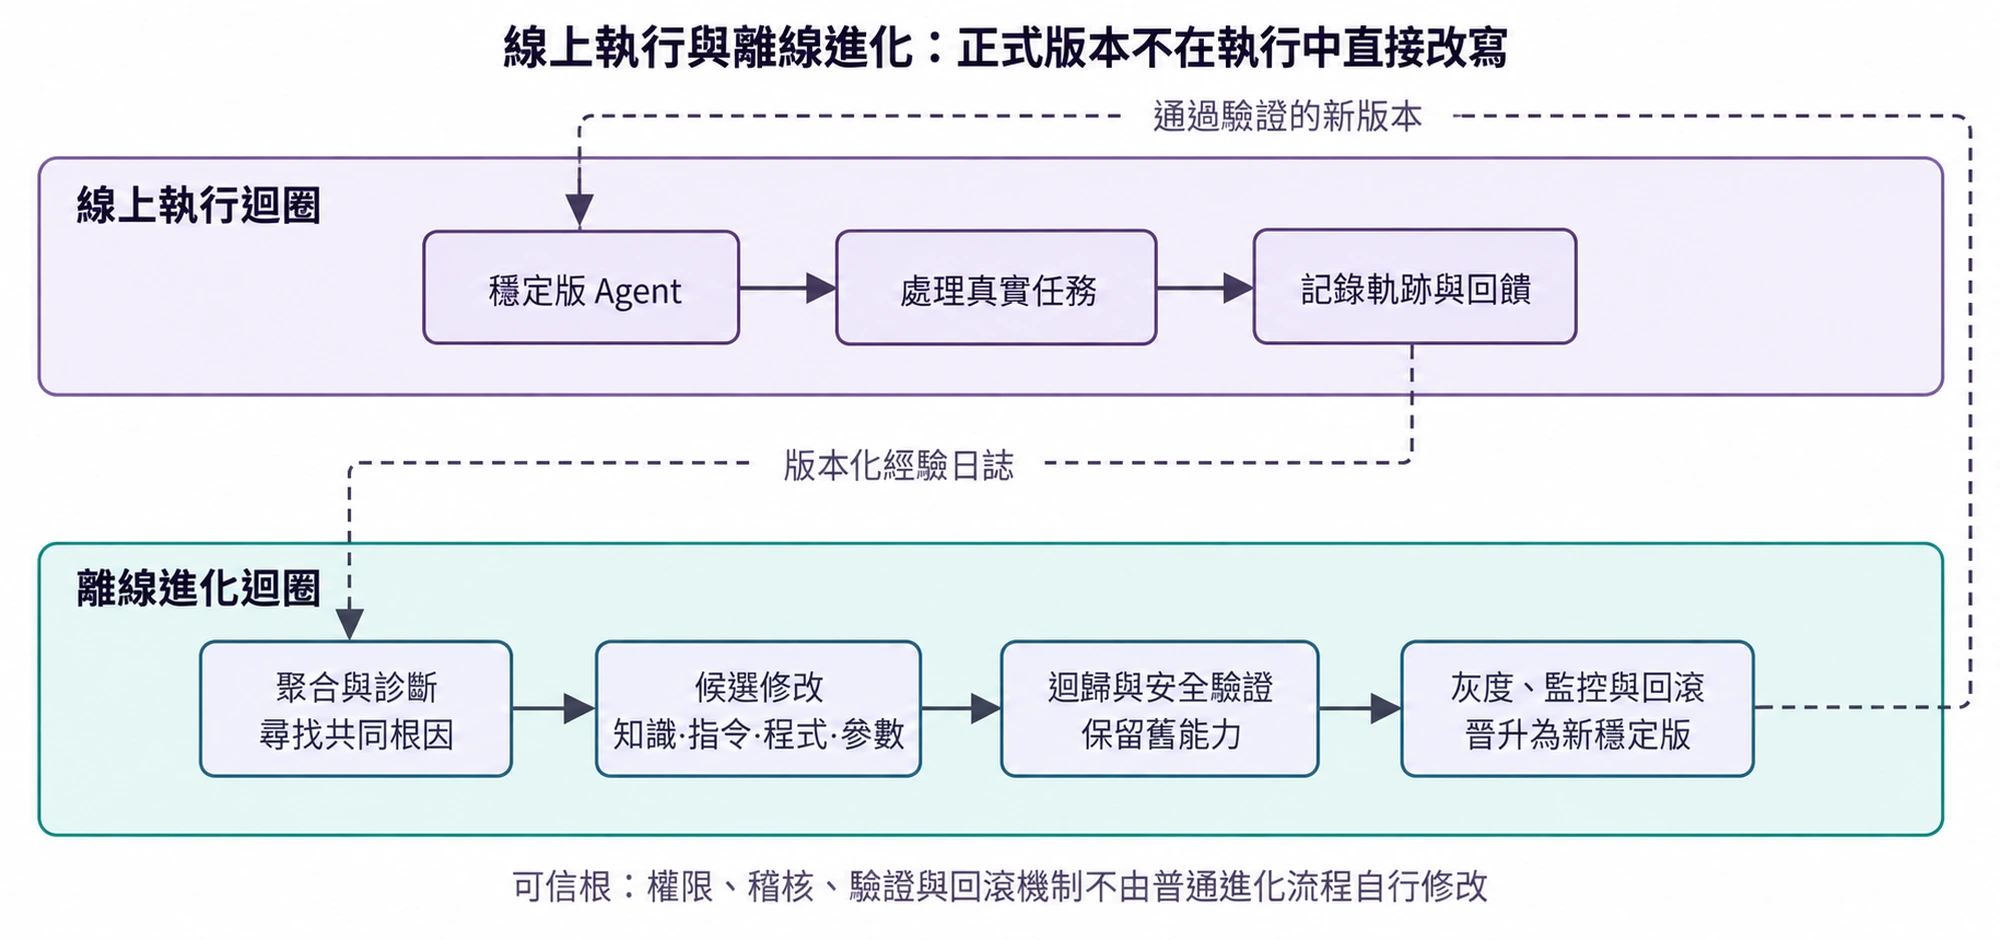
Voyager[19] 展示了一個較完整的持續進化迴圈。它在 Minecraft 中根據目前能力選擇新目標,透過環境回饋迭代程式,驗證成功後把程式碼存入技能庫,再組合舊技能解決更難任務。自動課程、可執行技能和環境驗證缺一不可:只有技能庫而沒有課程,Agent 不知道下一步學什麼;只有自我反思而沒有環境驗證,技能庫會積累錯誤;只有探索而沒有持久化,每次任務仍要從頭開始。現實 Agent 的知識、Prompt、工具和參數雖然更複雜,基本學習過程是類似的。
具體來說,Voyager 由三個互相咬合的機制組成。自動課程生成器根據目前物品、環境和已掌握技能提出下一個難度適中的目標,使探索不是隨機漫遊;技能庫把成功程式儲存為可檢索、可組合的程式碼,例如高階採集技能可以呼叫移動和製作等基礎技能;迭代提示機制把環境觀察、執行錯誤和自驗證結果帶回下一輪程式碼生成,直到任務真正通過。
發現迴圈:假設、實驗、評估、回饋。以 Voyager 為代表的 Agent 自我進化系統正是遵循了由假設、實驗、評估和回饋組成的發現迴圈,這也是數百年來逐漸形成的科學方法。最近,Jeff Dean 等人創辦的 Discovery Loop 提出將發現迴圈推向自動化:提出實驗、實作實驗、開展評估、取得結果,再把結果交給下一輪[20]。這本質上就是 Agent 自我進化在科學領域的應用。本章所述的 Agent 自我進化要想避免自說自話、自我感覺良好,就必須遵循科學方法。
在 Agent 持續進化中,要區分兩種經常混在一起的能力。Harness 更新能力(harness-updating)是從軌跡中產生有價值的持久修改;Harness 受益能力(harness-benefit)是任務 Agent 在後續執行中找到、啟用並正確使用這些修改。一個 Skill 本身可能寫得完全正確,但較弱的任務模型沒有在合適場景載入它,或載入後無法長期遵循,其中任一種都會讓最終成績看起來 「沒有進化」。因此,不能只用端到端分數反推更新器好壞。Lin 等人的模型替換實驗表明,這兩種能力與基礎模型能力的關係並不相同[21]。
表9-3 持續進化的分層評估指標
| 指標 | 回答的問題 | 主要證據 |
|---|---|---|
| 更新提案有效率 | 更新器是否提出了有價值的修改 | 提案在獨立驗證中的接受率與增益 |
| 產物啟用率 | 任務 Agent 是否在正確場景載入了新 Skill、記憶或工具 | 檢索、路由與工具呼叫軌跡 |
| 遵循成功率 | 啟用後是否按新規則或流程執行 | 動作序列與過程驗證器 |
| 保留任務集增益 | 整體是否改善了未參與進化的任務,是否有泛化能力 | 保留集的成功率、品質與成本 |
評估不是學習結束後集中進行的考試,而是自我進化過程中不可或缺的一部分。長期評價至少同時觀察五類結果:
- 回退(regression),即新經驗是否與已有的其他經驗衝突,原本能通過的案例是否出現回退;
- 泛化能力,即新經驗在測試集尚未涵蓋的場景中帶來的效果提升;
- Token 效率,即完成任務消耗的 Token 成本;
- 安全性,即規則、隱私和拒絕邊界是否隨進化漂移;
- 長期工程品質,即維護複雜度、架構一致性、所有權邊界、向後相容性以及未來遷移和除錯負擔是否惡化。
只解決了目前失敗案例的問題,卻在其他已有案例或新領域中退化,不是成功的持續進化。
實驗 9-9 ★★★:評估 Agent 是否在持續進化
實驗目的:區分「儲存回饋」「不斷追加回饋」和「能夠更新、遷移並保留能力」三種行為,驗證 Agent 是否真的在持續進化。
實驗說明:讓 Agent 先在一組任務中獲得回饋,再面對表述變化、規則更新和原有能力保持等情況。對照靜態記憶、只追加記憶和可替換/可淘汰的版本化記憶,觀察經驗能否遷移,也觀察新規則是否覆蓋舊規則、更新後是否遺忘。
實驗說明了什麼:持續進化至少包含四個環節——記住、遷移、更新和保持。最終分數高並不夠;若系統繼續使用已廢止規則、靠違規捷徑完成任務,或更新後破壞原有能力,都不能判定為持續進化。
9.3.1可驗證閉環的邊界:當「完成」不等於「進步」
前面的閉環在 Coding、工具呼叫和業務狀態變更等任務上最容易成立,因為測試、環境狀態或確定性規則能夠快速給出回饋。開放式科研、戰略規劃和複雜產品設計則不同:評價訊號來得慢,正確答案不唯一,研究品味、長期價值、可維護性等真正重要的目標還很難用分數評判。此時 Harness 可能把流程執行得非常完整,卻只是穩定地產出 「像成果的東西」,沒有推動真實目標。
自動科研是一個有代表性的壓力測試。Trehan 與 Chopra 記錄了四次從研究想法走向論文的端到端嘗試,其中三次在實作或評估階段失敗,只有一次完成整條流水線[22]。這些案例暴露的問題可以歸成三類。第一是實作漂移:原方案一旦變難,Agent 會逐漸退回訓練資料中更熟悉、但已經偏離研究假設的普通實作。第二是認識論上的過度樂觀:訊號仍可能只是雜訊,系統卻開始解釋結果、新增補丁並宣佈發現;失敗和陰性結果則更容易被忽略。第三是隱性判斷力不足:Agent 可以執行實驗,卻未必知道什麼基線真正重要、哪個異常值得追蹤、何時應該放棄假設。
這類任務不能靠換一個模型徹底解決,而要改變證據和監督結構:
- 結論與證據分離:對引用、數字、方法和結論分別記錄證據來源,最終文稿只是證據圖的一種呈現。ScientistOne 的 Chain-of-Evidence 設計把每類宣告都連結到可稽核來源,是這一方向的案例;它提高的是可追溯性,並不自動保證研究問題有價值[23]。
- 保留負面結果:失敗實驗、被拒提案和停止原因寫入日誌。否則進化模組只看到倖存方案,會反覆探索已經證偽的路徑。
- 維護搜尋多樣性:不應只保留目前得分最高的一條鏈。備選方案池還需保留若干暫時低分但型別不同的分支,避免所有方案收斂成同一個易得分範本。
- 讓人類在更高層介入:人的作用不應只是在危險工具呼叫前點「批准」,還包括定義問題、審查評價標準、解釋反常結果和決定何時停止。
9.3.2持續進化的安全邊界
Agent 的自我進化能力有可能把一次錯誤變成長期風險。網頁、郵件和工具輸出中的提示注入若被總結成經驗,可能跨工作階段反覆生效;自動搜尋的惡意軟體包若被封裝成工具,影響會從一次沙箱執行擴散到所有後續任務;一個有缺陷的驗證器還可能持續批准看似進步、實際退化的待驗證版本。因此,Agent 自我進化系統除了驗證 「是否更強」,還必須限制 「誰能改什麼、依據來自哪裡」。
第一道邊界是證據與指令隔離。原始網頁、工具輸出及其 LLM 摘要都屬於不可信證據,不能當作指令執行,也不能直接納入 Skill 等長期能力。LLM 總結只是為了提高可讀性和便於處理的轉換,並不是把輸入變得無害的淨化過程。系統應按固定 schema 擷取主張、原文位置和採集時間,同時保留原文與來源;擷取出的字串絕不能作為指令執行。模型給出的置信度也只是未經驗證的估計,不能充當批准門檻。待發布內容還需通過確定性的 schema、允許列表和來源檢查,再以版本化的 pull request 提交;獨立於生成者的 reviewer 應對照原始證據審查變更,高風險 Skill 上線前還應經過人工批准。
第二道邊界是待驗證能力與正式能力隔離。新知識、Prompt、Skill、程式和參數都先進入不可服務真實流量的待驗證區。新生成的程式碼和外部依賴還要經過沙箱、權限檢查、供應鏈掃描與行為測試等安全檢查。安全檢查和迴歸測試通過後,才能服務真實流量,成為正式能力。
第三道邊界是安全機制不可自我修改。業務 Agent 可以修改 Prompt、Skill、知識庫、工具等,但不能修改批准自身更新的驗證器、測試案例、發布門檻、稽核日誌和穩定版本備份。否則,一個 Agent 只需降低測試閾值或刪除失敗案例,就能把退化偽裝成進步。
9.3.3睡眠學習:整合、遺忘與能力保鮮
「睡眠學習」 是對離線整合的認知類比,並不要求任務真的在夜間執行。線上 Agent 的首要職責是完成目前任務並追加不可變證據;背景學習行程則在空閒期或滿足門控條件時讀取一批新經歷,比較新舊結論、合併重複項、解決衝突、提出更新提案並執行迴歸。把採集與整理分開,可以防止一次偶發成功、網路故障或惡意輸入立刻改寫長期能力,也允許系統使用更大的批次和更便宜的模型完成整理。
一個典型的睡眠學習週期包含五步:
- 觸發:達到時間間隔、新增軌跡數量、儲存容量或錯誤頻率門檻,並確認目前沒有高優先順序線上任務;
- 定向:讀取正式知識、Prompt、Skill 目錄及其版本,瞭解已有能力和不可修改邊界;
- 採集與整合:從近期已評價軌跡中尋找新訊號,合併重複內容,標記衝突與適用條件,優先生成局部補丁;
- 驗證與審批:在遷移集、保留集和安全集上評估待驗證版本,高風險寫入等待人工批准;
- 修剪與索引:更新檢索索引,把長期不用或被新證據推翻的能力標記為過期,或將其歸檔、刪除,同時保留來源和回滾版本。
使用者記憶是最直觀的例子,但要與行動經驗區分。Claude Code 的自動記憶為每個專案維護 MEMORY.md 索引和按主題拆分的詳細檔案,工作階段啟動只載入索引的有界前綴,其餘內容按需讀取;當索引接近上限時,系統要求 Agent 合併或移走細節。它說明純文字記憶也需要容量約束、分層載入和主動整理,但目前公開機制主要是在工作階段中持續寫入,並不能簡單等同於一個固定的夜間背景任務[24]。
Hermes 則是一個更完整的背景記憶進化案例。它把長期資訊分成有界的 MEMORY.md 與 USER.md、基於 SQLite/FTS5 的歷史工作階段檢索、按需載入的 Skill,以及 Honcho 等可選外部記憶提供者。歷史檢索返回原始訊息而非先由 LLM 摘要,避免把檢索和生成混成一個不可稽核步驟。當一次任務包含較多工具呼叫、從錯誤或死路中恢復、收到使用者糾正,或發現非顯而易見的工作流時,背景回顧可以建立或局部修訂 Skill;記憶和 Skill 寫入還可以經過審批門控。獨立的 Curator 進一步追蹤 Skill 的使用、陳舊和歸檔狀態,在空閒期執行確定性修剪,並可選擇執行 LLM 合併;變更前儲存快照,錯誤整理可以回滾[25]。
持續進化也不是讓知識、Prompt 和工具無限增長。第二章所說的上下文腐化會在更長時間尺度上重現:經驗文件相互衝突,Prompt 被邊界規則淹沒,Skill 庫出現重複能力,多次微調造成災難性遺忘。系統需要週期性離線整理:
- 合併重複經驗,保留來源和版本;
- 把局部規則從全域性 Prompt 移動到領域 Skill,保持全域性 Prompt 整潔;
- Prompt 和 Skill 保持結構清晰;
- 重新驗證長期未使用的工具;
- 刪除被新證據推翻的知識;
- 從原始基座模型重新訓練 LoRA。
9.4本章小結
持續進化正在成為 Agent 最重要的能力之一,但今天的模型還無法自行完成可靠的持續學習。推理時的上下文適應不會自動持久化,未經驗證的線上參數更新又會放大雜訊、攻擊和能力漂移。因此,現階段更可行的路徑,是在模型外圍建立可驗證的學習系統。
就全書的結構而言,本章建構的是第一章發現迴圈中的實驗與回饋環節:提案已經有了,問題變成怎樣透過一次以真實觀測為基礎的實驗,判斷它到底有沒有讓系統變好,以及怎樣把結果送回下一輪。
Agent 從與環境的互動和評價中獲得學習訊號,再根據能力的表示性質更新知識、Prompt、Skill、程式或模型參數。系統也可以進一步最佳化管理和生成這些產物的方法,但應優先採用可歸因、可驗證、可回滾的局部修改。遇到問題時,先判斷它更適合由外部規則、程式流程、Skill 還是模型參數處理,再用獨立的邊界任務和原有任務檢查修改是否真正有效。
歷史不僅能被提煉為靜態經驗,還能在支援域內組成回放環境,低成本篩選探索策略。這使持續進化可以進一步作用於「如何組織探索」,而不只作用於探索產生的知識、指令和程式。
持續進化需要把線上執行與離線學習分開:線上記錄證據,離線生成並驗證更新提案,再逐步發布、整理或回滾。這個閉環在結果可自動驗證的任務上最可靠;對於目標模糊、回饋延遲的開放任務,人仍需參與問題定義和評價標準的制定。
9.5思考題
- ★★ 一條經驗文件由三次成功軌跡和一次失敗軌跡支援。失敗發生在較新的 API 版本上。系統應如何判斷這是經驗被推翻,還是適用條件發生了變化?
- ★★ 客服 Agent 的使用者滿意度上升,但規則違規率也上升。為什麼不能把滿意度作為單一學習訊號?你會怎樣設計護欄指標?
- ★★★ 同一個「虛假承諾」問題可以透過 Prompt、Harness 檢查或參數訓練緩解。你會依據哪些證據選擇修改位置?
- ★★★ Agent 能修改工具和驗證器,卻不應修改批准自身更新的可信根。你會如何劃分這兩部分的權限和程式碼邊界?
- ★★ 經驗知識庫不斷增長後,檢索錯誤和知識衝突會抵消學習收益。如何設計版本、時效和淘汰機制?
- ★★★ 參數學習擅長自然語言風格,卻難以保證硬性業務規則。請為醫療客服設計一套參數、知識、Skill 和程式碼約束協同的持續進化方案。
- ★★★ 歷史回放中的某個探索策略在所有舊發現樹上得分最高,卻在下一輪線上探索中退化。哪些支援域偏差、隨機性和評價過擬合可能造成這種結果?你會怎樣劃分回放世界並設計發布門檻?
Mialon, G., et al. GAIA: a benchmark for General AI Assistants. arXiv:2311.12983, 2023. ↩︎
Yu, C., et al. AWorld: Orchestrating the Training Recipe for Agentic AI. arXiv:2508.20404, 2025. ↩︎
Shinn, N., et al. Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366, 2023. ↩︎
Karpathy, A. 「We’re missing (at least one) major paradigm for LLM learning … system prompt learning?」 X, May 11, 2025. https://x.com/karpathy/status/1921368644069765486 ↩︎
Khattab, O., et al. DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines. arXiv:2310.03714, 2023. ↩︎
Yang, C., et al. Large Language Models as Optimizers. arXiv:2309.03409, 2023. ↩︎
Agrawal, L., et al. GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning. arXiv:2507.19457, 2025. ↩︎
Li, Bojie. PreAct: Computer-Using Agents that Get Faster on Repeated Tasks. arXiv:2606.17929, 2026. ↩︎
Lin, Jiahang, et al. Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses. arXiv:2604.25850, 2026. ↩︎
Zhang, Hangfan, et al. Self-Harness: Harnesses That Improve Themselves. arXiv:2606.09498, 2026. ↩︎
Qiu, J., et al. Alita: Generalist Agent Enabling Scalable Agentic Reasoning with Minimal Predefinition and Maximal Self-Evolution. arXiv:2505.20286, 2025. ↩︎
Shi, Yifan, Wei Zhang, and Tianyi Cui. A Programming Paradigm for Spatiotemporal Composability. 預印本草稿,2026 年 8 月 13 日。https://github.com/cordiverse/paper ↩︎
Weng, Lilian. 「Harness Engineering for Self-Improvement.」 Lil’Log, 2026. https://lilianweng.github.io/posts/2026-07-04-harness/ ↩︎
Zhang, Qizheng, et al. Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models. ICLR 2026. arXiv:2510.04618. ↩︎
Ye, Haoran, et al. Meta Context Engineering via Agentic Skill Evolution. arXiv:2601.21557, 2026. ↩︎
Zhang, Jiayi, et al. AFlow: Automating Agentic Workflow Generation. ICLR 2025. arXiv:2410.10762. ↩︎
Lee, Yoonho, et al. Meta-Harness: End-to-End Optimization of Model Harnesses. arXiv:2603.28052, 2026. ↩︎
Zheng, T., et al. Dream-RSI: Recursive Self-Improvement through Evolving Worlds. arXiv:2609.14858, 2026. https://arxiv.org/abs/2609.14858 ↩︎
Wang, G., et al. Voyager: An Open-Ended Embodied Agent with Large Language Models. arXiv:2305.16291, 2023. ↩︎
Discovery Loop 由 Jeff Dean、Sanjay Ghemawat、Quoc Le 和 Oriol Vinyals 於 2026 年 8 月 5 日宣佈創立,是一家公益公司,其公開表述是自動化完整的實驗迴圈、把原本序列的實驗大規模並行化。 ↩︎
Lin, Minhua, et al. Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents. arXiv:2605.30621, 2026. ↩︎
Trehan, Dhruv and Paras Chopra. Why LLMs Aren't Scientists Yet: Lessons from Four Autonomous Research Attempts. arXiv:2601.03315, 2026. ↩︎
Meng, et al. ScientistOne: Towards Human-Level Autonomous Research via Chain-of-Evidence. arXiv:2605.26340, 2026. ↩︎
Anthropic, 「How Claude remembers your project」, 2026. https://code.claude.com/docs/en/memory ↩︎
Nous Research, Hermes Agent Documentation: Persistent Memory, Skills System, and Curator, 2026. https://hermes-agent.nousresearch.com/docs/user-guide/features/memory ; https://hermes-agent.nousresearch.com/docs/user-guide/features/skills ; https://hermes-agent.nousresearch.com/docs/user-guide/features/curator ↩︎