
第十章
多 Agent 協作
前九章圍繞單個 Agent 展開:先建構上下文、知識、工具與互動能力,再透過評估、後訓練和持續進化讓它長期變好。本章把問題從「如何建構和改進一個 Agent」推進到「如何組織多個 Agent」——讓它們透過分工、通訊與相互驗證完成單個 Agent 難以承擔的任務。
在 OpenAI 曾提出的五級 AI 能力框架(Level 1 對話者、Level 2 思考者(Reasoners)、Level 3 智慧體、Level 4 創新者、Level 5 組織(Organizations))中,多 Agent 協作常被類比為通向第五級的路徑之一——需要說明的是,此處 Organizations 指的是「AI 能完成整個組織的工作」這一能力級別,而非對系統架構的要求,足夠強大的單個 Agent 理論上也能達到。但就今天的工程現實而言,單個 Agent 終究受限於自身模型的能力邊界和上下文視窗。
而讓多個 Agent 協同工作,意義遠不止讓不同專長的 Agent 「取長補短」。更根本的一點是:群體的智慧可以高於個體。人類文明便是明證——單個人的智力有限,但經由分工、協作、辯論和知識的代際累積,人類社會作為整體所展現的智慧,遠超任何一位天才個體。Agent 群體同樣可能湧現出這樣的集體智慧:哪怕每一個 Agent 都只相當於人類專家的水平,只要組織得當,其整體能力也可能超過所有人類專家的總和。Google DeepMind 在《從 AGI 到 ASI》中正把「大規模多 Agent 集體」列為通往超級智慧(ASI)的關鍵路徑之一——正如人類的通用智慧能聚合成超越個體的社會與組織實體,眾多 AGI 級 Agent 協同形成的「群體智慧」,也可能表現出遠超其成員簡單相加的認知能力[1]。因此,多 Agent 協作不只是突破單個模型上下文視窗與能力邊界的工程手段,更可能是從「專家級 AI」邁向「超越人類整體」的一條根本路徑。
10.1多 Agent 協作的分類框架
要建構多 Agent 系統,首先需要理解兩個核心設計維度,它們共同決定了系統的基本架構和實作方式。
10.1.1維度一:上下文是否共享
這是最基礎的架構決策,決定了多個 Agent 之間如何傳遞資訊。
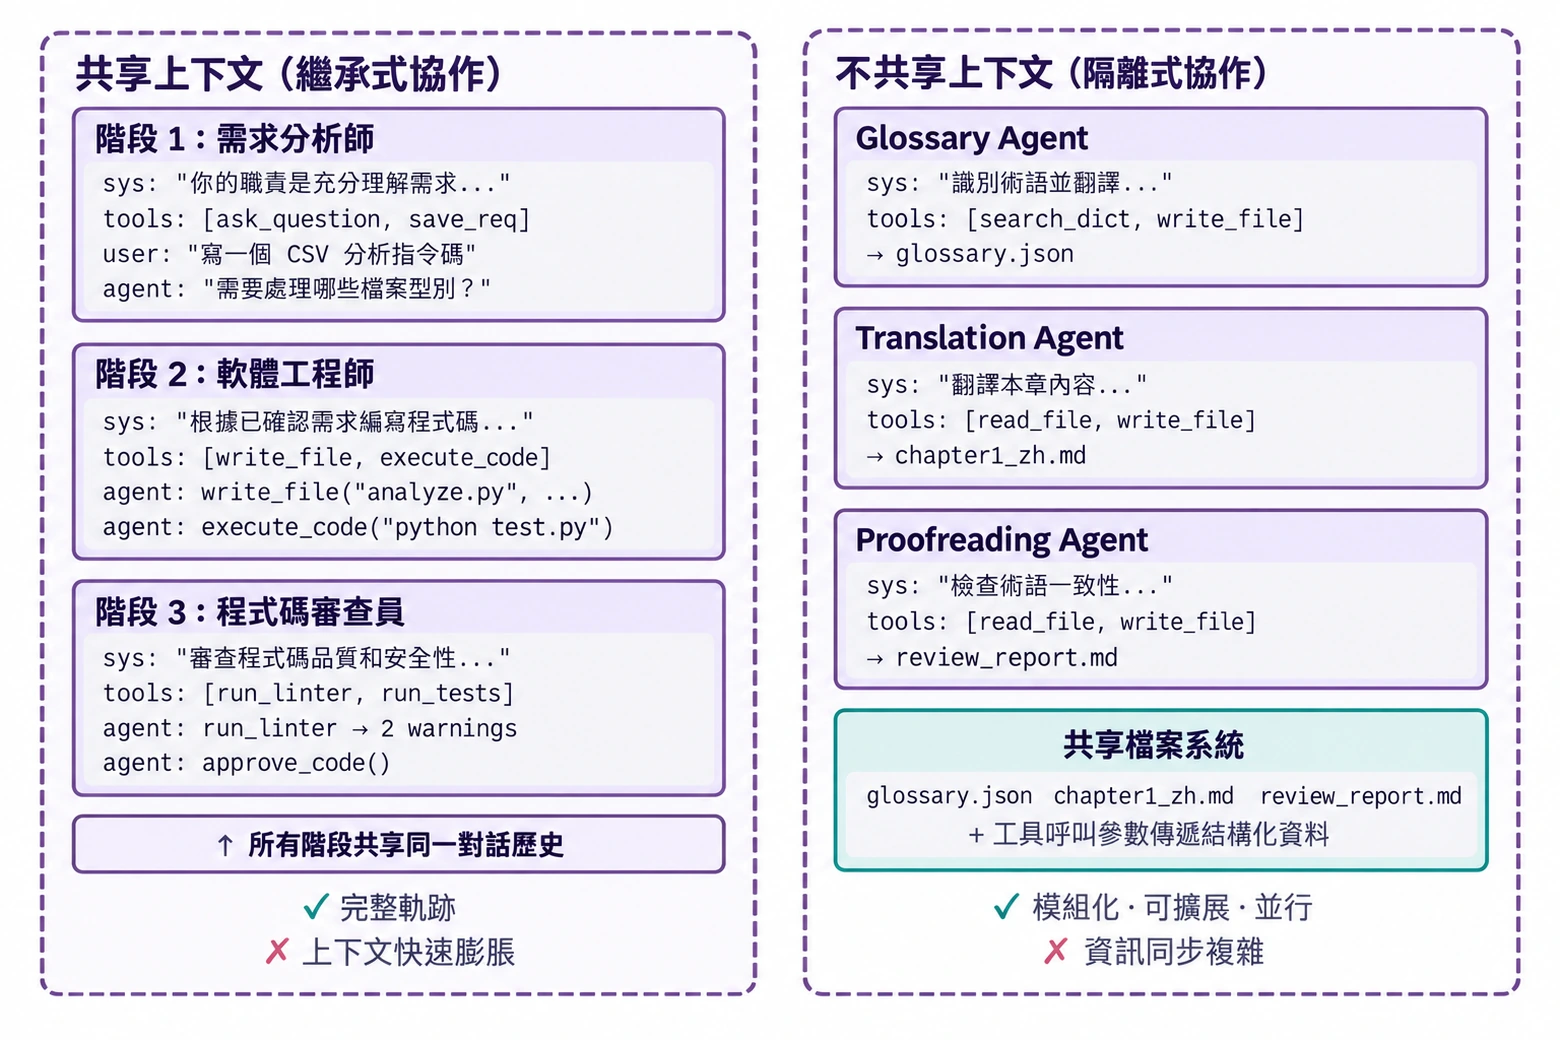
共享上下文意味著後續 Agent 接收前一個 Agent 的完整對話歷史和軌跡(第一章定義的 trajectory)。每個階段切換系統提示詞和工具集後,就變成了一個新的 Agent(因為它的身分、職責和能力都發生了變化),但它保留了前任的全部記憶。比如一個團隊裡,需求分析師寫完需求文件後,開發者不僅拿到了文件,還能看到分析師與使用者的所有溝通記錄——他是一個新角色,但完整保留了之前的上下文。優勢在於資訊不丟失,每個 Agent 都能回顧之前任何階段的細節;挑戰在於上下文可能快速膨脹。
不共享上下文意味著每個 Agent 維護完全獨立的上下文和對話歷史,彼此無法直接存取對方的「思考過程」。這就像不同部門之間的協作:每個人在自己的工位上獨立工作,透過共享文件和會議紀要交換資訊,而不是時刻盯著別人的螢幕。這種模式的模組化和隔離性更好,每個 Agent 只需關注與自身職責相關的資訊;系統也更易擴展和維護——增加新 Agent 不需要改動現有 Agent 的內部邏輯,只需定義好介面和資料格式。
由於 Agent 之間不共享上下文,必須透過明確的通訊機制傳遞資訊。這個問題在經典分散式系統中早有答案:作業系統教科書告訴我們,行程間通訊(IPC)歸根結底只有兩大範式——共享記憶體(一方寫入、另一方讀取同一塊儲存)和訊息傳遞(把資料明確地傳送給對方)。Agent 間的通訊機制同樣落在這兩個範式之內,常見的有三種:
- 工具呼叫的參數:把下游 Agent 封裝成工具,上游 Agent 把結構化資料透過工具參數傳給下游 Agent,適合需要型別確定、結構清晰的場景;
- 共享檔案系統:Agent 之間透過讀寫共享目錄下的文件、程式碼等中間產物來交換資訊,適合產物較大或需要持久化的場景;
- 訊息匯流排(Message Bus):一個專門負責在 Agent 之間傳遞訊息的中轉站,Agent 不直接呼叫彼此,而是把訊息傳送到訊息匯流排,由它轉發給目標 Agent。
對應到 IPC 的兩大範式:共享檔案系統就是 Agent 世界的「共享記憶體」;工具呼叫參數和訊息匯流排則是「訊息傳遞」的兩種形態——前者隨呼叫同步傳遞,後者經中轉站非同步投遞。兩種範式各有取捨。Go 語言有一句廣為流傳的話:「不要透過共享記憶體來通訊,而要透過通訊來共享記憶體」。
10.1.2維度二:協作拓撲
第二個維度是協作拓撲——Agent 之間的控制權和資訊按什麼結構流動。協作拓撲有三種典型形態:
- 對等協作模式(Peer Collaboration Pattern):少量 Agent 按照固定的拓撲形成迭代改進迴圈,例如論文寫作 Agent 由起草者和評論者兩個 Agent 組成,一方起草、另一方批註修改,反覆幾輪後品質更高。
- 管理者模式(Orchestration Pattern):一個中心化的 Manager Agent 負責任務規劃和排程,多個子 Agent 各負責特定子任務——就像專案經理帶著幾位專業工程師做專案。
- 去中心化模式(Decentralized Pattern):沒有執行時的中心控制者,Agent 之間像人類一樣互相溝通,協作完成任務。
術語說明:Graph 工程。 2026 年 7 月開始流行的 「Graph Engineering」,在目前 Agent 語境中通常指明確設計執行圖:節點是 Agent、普通程式或人工決策,邊定義任務依賴、條件路由與失敗後的去向,結構化狀態在節點之間流動(該名稱的由來與相關實踐見第一章「從提示工程到 Loop 工程」一節)。本章討論的「協作拓撲」正是其中的多 Agent 子集——對等協作、管理者編排和去中心化移交,都是不同的圖拓撲。
各模式的詳細設計和適用場景將在後面的專題小節中展開討論。
10.2多 Agent 何時真正優於單 Agent
在進入具體的協作架構之前,先回答一個更根本的問題:什麼時候真正需要多個 Agent,什麼時候一個 Agent 就夠了? 這個問題的答案會成為後文所有工程方案的總體參照。近年的一系列研究給出了一個清晰的判斷框架——核心判據只有一條:協作過程是否引入了單個 Agent 在生成時無法獲得的新資訊?
表10-1 彙總了不同協作模式是否引入新資訊,用來判斷多 Agent 協作相對單 Agent 是否具有實質價值。
表10-1 多 Agent 協作模式的資訊增量對比
| 協作模式 | 是否引入新資訊 | 效果 |
|---|---|---|
| 同一模型自我審查(重新閱讀自己的輸出) | 否 | 通常無效甚至有害 |
| 不同 Agent 辯論同一段文字 | 否 | 在等計算量下與單 Agent 持平 |
| 審核者使用測試執行結果審查程式碼 | 是(執行回饋) | 顯著提升 |
| 審核者檢視渲染截圖審查前端/PPT 程式碼 | 是(視覺回饋) | 顯著提升 |
| 審核者使用外部工具驗證事實 | 是(工具回饋) | 顯著提升 |
2025 年的 RLEF(Reinforcement Learning from Execution Feedback)[2] 證實了這一點:透過強化學習訓練模型利用程式碼執行回饋來迭代改良程式碼,效果遠超讓模型獨立多次取樣。關鍵在於每次迭代都引入了真實的執行結果(編譯錯誤、測試失敗、執行時異常),這些資訊在模型寫程式碼時並不存在。2025 年的 WebGen-Agent [3] 在網頁生成任務上,透過多層級的視覺回饋(截圖 + 視覺語言模型描述)構成的回饋鷹架,據報導使 Claude 3.5 Sonnet 在該基準上的表現從 26.4% 提升到 51.9%——接近翻倍。
這個「新資訊」框架解釋了一個看似矛盾的現象:一些學術研究認為多 Agent 並不能提升 Agent 能力上限,但在工程實踐中,多 Agent 確實表現得更好。矛盾的根源在於兩者討論的是不同型別的 「多 Agent」:學術研究中比較的多是 「多個 Agent 看著同一段上下文互相討論」 的模式,而工程實踐中有效的多 Agent 系統往往包含外部回饋環路(程式碼執行、視覺渲染、工具呼叫)。前者沒有引入新資訊,後者引入了。
Anthropic 2026 年的漏洞挖掘實驗給出了一個案例:45 個 Agent 透過共享論壇協調搜尋、互相審查,再由獨立 Agent 仲裁結果。Agent 叢集用 2700 萬 token 找到 266 個漏洞,而獨立 Agent 並行方案用 650 萬 token 只找到 21 個。在開放搜尋空間裡,多 Agent 透過互相通訊,可以動態轉移搜尋重點、形成專門分工,用更高 token 預算換取更廣的涵蓋範圍和更多樣化的發現路徑。[4]
步驟預算與 Agent 效能。 一個相關的研究方向是:給 Agent 分配不同的步驟預算(即允許的工具呼叫次數或迭代輪數),會如何影響其表現?直覺上,更多步驟應該帶來更好的結果——30 步預算下 Agent 只能快速實作核心功能,300 步預算下它還可以先做規劃、再實作、再測試、再改進。但 2025 年 Google 的論文《Budget-Aware Tool-Use Enables Effective Agent Scaling》發現了一個反直覺的結論:單純增加 Agent 可用的步驟數並不能保證效能提升。標準的 Agent 缺乏「預算意識」——即使有 300 步的預算,它們仍然傾向於執行淺層搜尋,很快就「飽和」了。要讓更多的步驟真正轉化為更好的結果,Agent 需要一種明確的預算感知機制,根據剩餘資源動態調整策略:前期廣泛探索,後期聚焦最有希望的方向。2026 年的 BAVT(Budget-Aware Value Tree Search)進一步提出了步驟級別的價值評估,在每一步根據剩餘預算比例調整探索與利用的權重——隨著預算減少,Agent 從「廣撒網」逐漸切換到「深挖掘」。
這些發現對多 Agent 系統設計有直接的指導意義。比如在管理者模式中,Manager Agent 不應只是簡單地將任務分發給子 Agent 然後等待結果,而應該根據任務的複雜度動態分配步驟預算——簡單子任務給較少的步驟,複雜子任務給充足的步驟。同時還要引導子 Agent 合理利用這些預算(先規劃、再實作、再測試、再改進),而不是一頭扎進去直接開幹。
此外,成本是多 Agent 系統必須關注的要點。多 Agent 的並行探索與反覆迭代都要消耗大量 token。這意味著多 Agent 帶來的收益必須足夠大,能夠覆蓋數倍乃至一個數量級的額外開銷,否則一個調校得當的單 Agent 往往是更划算的選擇。
10.3共享上下文的多 Agent 協作
共享上下文的多 Agent 協作中,每個階段都是一個獨立的 Agent(擁有自己的系統提示詞和工具集),但它繼承了前序 Agent 的完整軌跡——就像接班的同事能翻閱前任留下的所有工作日誌。這種 「繼承式協作」 的核心優勢在於資訊不會丟失,每個 Agent 都能回顧之前任何階段的細節。挑戰則在於如何讓目前 Agent 專注於自己的核心職責,而不被繼承來的大量歷史資訊所干擾。
在複雜任務中,Agent 的角色和職責可能在不同階段發生顯著變化。如果始終使用同一套靜態系統提示詞,要麼過於籠統缺乏針對性,要麼把所有階段的指導塞在一起導致過於冗長。多階段角色轉換的做法是:根據目前階段動態切換系統提示詞和工具集,讓 Agent 在每個階段都以最合適的 「身分」 工作。
這裡有一個常被忽略、但會直接改變架構的設計選擇:角色轉換究竟是替換 system prompt,還是載入 Skill? 兩者都可以讓同一個模型在不同階段採用不同的行為規程,卻不是同一種成本模型。
| 選擇 | 角色規程的載體 | 工具可見性 | 上下文/KV Cache 影響 | 約束能力 |
|---|---|---|---|---|
transfer_to_agent |
替換目前 system prompt,並通常替換工具集 | 只暴露目前角色工具 | 每次切換都改變請求前綴;從變化點起的前綴快取通常無法重用 | 強:越界工具可在 schema 層不可見 |
| Skill | 固定 system prompt 中的 Skill 目錄,按需把 SKILL.md 追加到軌跡 |
通常固定暴露工具全集,或使用穩定的工具搜尋入口 | 靜態前綴保持不變;Skill 內容成為末尾軌跡,已有前綴可繼續重用 | 弱:Skill 是行為指令,硬權限仍需 Harness 門 |
角色差異主要來自知識、流程和寫作風格時,優先使用 Skill;角色差異涉及權限、工具隔離、合規邊界或需要在執行時強制禁止某類動作時,使用獨立 Agent 或 transfer_to_agent 工具,並在 Harness 層透過程式碼限制工具呼叫。
實驗 10-1 ★★:共享上下文中的多角色轉換——系統提示詞與 Skill 的對比
共同任務與變數:兩條路徑都使用同一模型、同一使用者任務、同一工具實作、同一份角色規程和全量共享軌跡。任務是查詢中國 2021—2023 年新能源汽車銷量、計算 CAGR、寫不超過 120 字的投資人摘要。
路徑一:系統提示詞切換。五種角色為 triage(使用者需求收集,預設入口)、research(資訊檢索)、coding(程式設計)、data_analysis(資料分析)和 writing(寫作)。每個角色只看到自己的專屬工具和 transfer_to_agent;呼叫移交時儲存歷史、載入目標角色提示詞/工具集,再繼續呼叫。舊實作保留在配套專案中,作為這一實驗分支的基線。
路徑二:Skill。system prompt 和完整工具全集在整個工作階段中固定;模型按需呼叫 load_skill(name),讀取的 SKILL.md 作為 tool result 進入共享軌跡。這樣靜態前綴不因角色變化而重寫,但工具仍然可見,硬權限由 harness 中的規則保證。
10.4不共享上下文的多 Agent 協作
不共享上下文代表真正的多 Agent 協作。在這種架構下,每個 Agent 都是獨立的實體,擁有自己的上下文、軌跡和狀態;彼此無法直接存取對方的 「內心活動」,協作完全依賴本章開頭介紹的三種通訊機制(工具呼叫參數、共享檔案系統、訊息匯流排)。
沿著開頭那條「通訊機制即行程間通訊」的線索再往前走一步,會發現多 Agent 系統與作業系統的對應關係相當完整(表10-2):
表10-2 多 Agent 系統與作業系統的對應關係
| 作業系統 | 多 Agent 系統 |
|---|---|
| 程式(執行檔) | 靜態前綴(系統提示詞 + 工具定義) |
| 行程的記憶體 | 軌跡 |
| CPU | LLM |
| 核心 | Agent 執行環境 |
| 系統呼叫 | 工具呼叫 |
| fork(建立子行程) | spawn_subagent |
| kill(傳送訊號) | cancel_subagent |
| ps(列出行程) | list_agents |
| 退出碼與 wait() | 子 Agent 返回的結構化摘要 |
| 共享記憶體 / 訊息傳遞 | 共享檔案系統 / 訊息 |
這套抽象並不新鮮:私有狀態、非同步訊息、可建立新成員,正是 1970 年代 Actor 模型的基本設定[5],多 Agent 系統不妨看作它的 LLM 版本。因此作業系統與分散式系統的成熟經驗大多可以直接借用。
行程式的隔離帶來了幾個切實的工程好處:每個 Agent 可以獨立開發和測試,新增能力不需要改動現有程式碼,某個 Agent 出了故障也不會把錯誤狀態傳染給其他 Agent,而且多個 Agent 可以真正併發執行——上下文完全獨立,不存在資源競爭。
但不共享上下文也有代價。最明顯的是資訊同步問題:各 Agent 如何對任務狀態保持一致的理解?資訊在傳遞過程中會不會丟失或重複?除錯也變得更加困難——出了問題需要翻看多個 Agent 的日誌,才能拼出完整的執行過程。這些問題使得介面規範、資料格式和通訊協定的設計變得至關重要。
不共享上下文的明確協作依賴兩套與拓撲無關的基礎設施。其一是共享檔案系統,作為 Agent 間交換產物、與使用者交換檔案的持久媒介,構成協作的資料平面;其二是通訊與控制機制,支援 Agent 間的訊息傳遞、狀態查詢、執行終止與資源排程,構成協作的控制平面。
10.4.1Agent 眼中的檔案系統
在實際系統中,Agent 存取的並非單一儲存,而是一個虛擬檔案系統(virtual filesystem):來源、生命週期與權限各異的儲存被掛載(mount)到同一目錄樹下,Agent 透過統一的 read_file/write_file/list_dir 介面存取,底層則可能是本地臨時盤、持久物件儲存、第三方雲盤的 API 或唯讀的系統資源包。明確這棵目錄樹的構成(每一區域的可見性與生命週期)是多 Agent 協作設計的前提:相當一部分併發衝突與資訊洩露,源於將本應隔離的區域混置。這棵目錄樹相當於 Agent 的地址空間,四類區域就是權限各異的記憶體段:有的私有可寫,有的多方共享,有的唯讀。
一個成熟的多 Agent 系統,其檔案系統通常由以下四類區域構成:
一、Agent 專屬工作區(Scratchpad)。每個 Agent 例項獨享的私有目錄,存放中間產物、臨時檔案、草稿與除錯日誌,生命週期與例項綁定,對其他 Agent 和使用者不可見。隔離 scratchpad 有兩重作用:避免多個 Agent 的臨時檔案相互覆寫,以及保持主 Agent 上下文的精簡——子 Agent 的試錯過程留存於自身工作區,僅將最終產物提交至共享空間。這是第四章「子 Agent 返回結構化摘要而非全量軌跡」在儲存層面的體現。
二、多 Agent 共享空間(Shared Workspace)。多個 Agent 共同讀寫、且使用者可見的協作區域,是不共享上下文架構下 Agent 間交換產物的主要媒介:Glossary Agent 寫入術語表,Translation Agent 從中讀取;使用者亦可在此上傳原始檔案、下載最終交付物。其生命週期與整個任務綁定,需要持久化。作為多方併發讀寫的區域,它是併發衝突的高發處——樂觀鎖、工作副本隔離(worktree)等機制均作用於此,詳見本章後文 「失敗模式一」。第四章以卷掛載 /workspace/shared 連接主 Agent、虛擬電腦與虛擬手機,即為這一層的典型實作。
三、外部掛載資源(Mounted External Resources)。使用者授權接入的第三方資訊源——Google Drive、Notion、Dropbox、企業 Wiki 等——透過介面卡(adapter)對映為檔案系統中的掛載點(如 /mnt/gdrive)。Agent 以讀檔案的方式存取一篇 Notion 文件,底層由介面卡呼叫對方 API 完成。這一層有三項區別於本地儲存的特性,需要在設計時明確處理:存取受外部權限約束(使用者在源系統中的權限決定 Agent 的可見範圍)、延遲更高且一致性更弱(每次讀取為一次網路往返,資料可能已被外部修改,只能按最終一致性對待)、以按需唯讀為主(寫回外部源須謹慎,誤寫可能汙染使用者的真實資料)。統一的檔案介面使 Agent 無需為每個資料來源定製專用工具,但也掩蓋了上述效能與安全差異,因此需在掛載層面明確管理唯讀/可寫、逾時與憑證邊界。
四、系統內建資源(Built-in System Resources)。系統預置、對所有 Agent 唯讀共享的資源包,典型代表是第二章、第四章介紹的 Skills——以檔案形式組織的知識文件與指令碼,掛載於 /skills 等路徑,按漸進式披露(先索引、後按需展開)取用;此外還包括參考手冊、範本庫與共享工具定義。該層全域性共享、唯讀、跨工作階段穩定,可被所有 Agent 併發讀取而無需併發控制。
圖10-2 呈現了這四類區域統一掛載於同一目錄樹的結構:Agent 透過統一介面存取整棵樹,使用者從共享空間上傳與下載檔案,外部資料來源經介面卡掛載,系統內建資源則以唯讀方式提供。
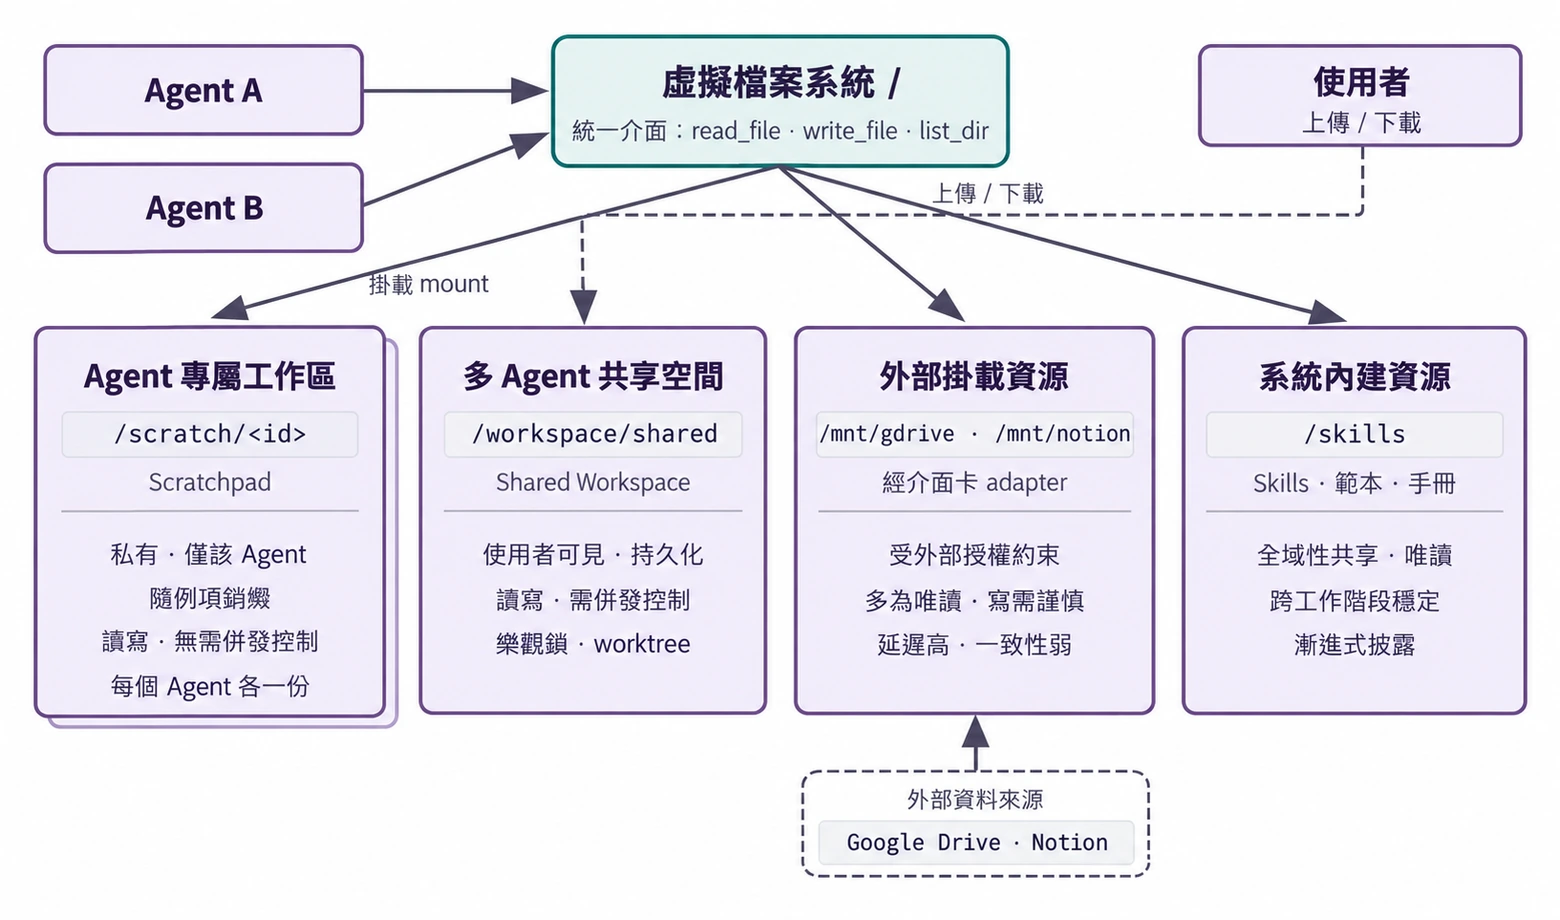
表10-3 從可見性、生命週期、讀寫權限與併發控制四個維度對比這四類區域,可作為檔案系統布局設計的檢查表。
表10-3 Agent 虛擬檔案系統的四類區域
| 區域 | 可見性 | 生命週期 | 讀寫 | 併發控制 |
|---|---|---|---|---|
| Agent 專屬工作區 | 僅該 Agent | 隨 Agent 例項銷燬 | 讀寫 | 不需要(私有) |
| 多 Agent 共享空間 | 所有協作 Agent + 使用者 | 隨任務持續,需持久化 | 讀寫 | 需要(樂觀鎖 / worktree) |
| 外部掛載資源 | 視外部授權而定 | 由外部源決定 | 多為唯讀,寫需謹慎 | 由外部源負責 |
| 系統內建資源 | 所有 Agent | 跨工作階段穩定 | 唯讀 | 不需要(唯讀) |
將四類區域統一至同一目錄樹,正是「檔案路徑作為通用介面」這一設計的價值所在:Agent 間傳遞產物、主 Agent 向子 Agent 交接輸入、乃至跨組織 A2A 協作交換產物,傳遞的均為輕量的路徑字串,而非將內容載入上下文視窗(第四章)。
10.4.2Agent 間的通訊與控制
檔案系統解決了 Agent 間產物交換的問題,協作還需要一條控制平面。這正是表10-2 中生命週期各行的用武之地:第四章給出的這組工具原語——建立(spawn_subagent)、發訊息(send_message_to_subagent)、取消(cancel_subagent)、發現(list_agents)——對應行程世界的 fork、訊息、kill 和 ps。
一、訊息傳遞。 最簡形態為點對點:Agent A 直接呼叫 send_message_to_agent_b(content),適用於拓撲固定、Agent 數量少的場景(如本章實驗 10-3 的電話 + 電腦雙 Agent)。當 Agent 數量增多且需非同步並行時,點對點連線數隨 Agent 數呈平方增長,且要求收發雙方同時線上;此時應改用訊息匯流排(詳見本章後文「並行協調形態」):Agent 將訊息發布至匯流排,由匯流排按訂閱關係轉發,傳送方無需知曉消費者。無論點對點還是經匯流排,訊息通常應攜帶結構化的信封(envelope):傳送者 ID、目標(指定 Agent 或廣播)、訊息型別(如 task_assigned/status_update/result/terminate)及 JSON 負載。統一的信封格式保證接收方能夠可靠地路由和解析訊息,並使協作鏈路可追溯——這是多 Agent 系統除錯的關鍵。
二、狀態查詢。 這是控制平面中最易被低估的一環。主 Agent 派出子 Agent 後,若無從獲知其進展,則既無法判斷是否繼續等待,也無法在其阻塞時及時介入。直觀的做法是定義一個 get_subagent_status(agent_id) 查詢介面,返回 「執行中/已完成/失敗」 等狀態。但這種拉取式介面並不實用:子 Agent 一經建立就立即開始執行,直到完成或失敗,子 Agent 完成時自然會通知主 Agent,並不需要主 Agent 明確查詢。狀態獲取更自然的做法,是回到本章開頭的兩大通訊範式。
用訊息傳遞獲取狀態。主 Agent 直接給子 Agent 發一條訊息:「進展如何?」子 Agent 在合適的時機回覆。一切都是非同步的:發出訊息不阻塞自己的執行,對方何時回覆、是否回覆是另一回事——正如經理透過即時訊息詢問下屬進度,而不要求對方立即停下手頭的工作。反過來,子 Agent 也可以在到達關鍵節點時主動發訊息彙報;系統若已架設訊息匯流排,這就是往匯流排上發布一條 status_update(實驗 10-4 的「即時監控」即此形態)。無論問答還是主動彙報,訊息中的狀態本身宜採用統一的狀態機詞彙(執行中、需要輸入、已完成、失敗)——本章後文的 A2A 協定正是把任務生命週期標準化為這樣一組狀態。
用共享檔案系統獲取狀態。最徹底的形態是軌跡持久化(trajectory persistence):子 Agent 在執行過程中,把自己的軌跡(第一章定義的 trajectory——使用者訊息、模型回覆、工具呼叫與結果的完整序列)即時序列化為 JSON,追加寫入檔案系統中的日誌檔案(通常每個工作階段一個檔案、每行一個事件,即 JSONL 格式)。主 Agent 無需任何狀態上報協定,直接讀取這個檔案就能看到子 Agent 的全部執行過程:它正在呼叫哪個工具、最近一步在思考什麼、是否卡在反覆失敗的重試上。用行程的語言說,這相當於直接讀另一個行程的記憶體。
但軌跡持久化不宜作為 Agent 間資訊傳遞的主要方式。軌跡動輒數萬 token,主 Agent 讀完還得自行提煉,既費時又費 token。因此多數場景下更合理的是約定進度檔案:主 Agent 啟動子 Agent 時約定「把進度寫到 progress.md」,子 Agent 每完成一項就更新這份任務清單,主 Agent 隨時讀這個輕量檔案即可掌握進展。這相當於兩個行程在共享記憶體裡劃出一小塊約定格式的狀態區,暴露的是提煉後的進度,而非全部記憶體。進度檔案還可以用於偵測卡住狀態:progress.md(或軌跡檔案)的最後修改時間超過 N 分鐘沒有變化,即可判定子 Agent 無活動、觸發逾時兜底,避免系統被阻塞的子 Agent 拖累。
三、執行終止。 並行協作中常出現「一個任務成功,其餘任務便無需繼續」的情形——多個 Agent 分頭搜尋,一個 Agent 命中目標後,其餘 Agent 應立即停止(本章實驗 10-4 的級聯終止)。終止有兩種強度,Unix 使用者會認出這正是 SIGTERM 與 SIGKILL 的區別。
優雅終止為首選:主 Agent 發出 terminate 訊號,子 Agent 在目前步驟的安全點回應,先清理資源(關閉瀏覽器工作階段、寫入未完成檔案、釋放鎖),返回確認(ack)後退出。強制終止為兜底:直接終止行程,僅在子 Agent 對優雅訊號無回應時使用,代價是可能遺留懸掛資源與未完成寫入。
還剩一個問題:主 Agent 終止後,仍在執行的子 Agent 怎麼辦?工程上最簡潔的做法借鑑 Go 的 context,終止沿建立關係向下級聯:取消一個 Agent,它派生的所有子 Agent 隨之取消,從根上杜絕無人認領的孤兒 Agent。上文 「子 Agent 在安全點檢查終止訊號」,對應的正是 Go 中對 ctx.Done() 的輪詢。反過來,若確實需要一個脫離主 Agent、長期執行的背景 Agent(類似 Unix 的 nohup),就讓它從一棵新的生命週期樹起步(對應 context.Background()),明確宣告不隨父級終止。
四、資源與排程。 作業系統的一個重要職能是分配稀缺資源。行程世界稀缺的是 CPU 時間和記憶體,Agent 世界稀缺的是 token 和併發額度。這項職能通常落在管理者 Agent 或執行環境身上:啟動子 Agent 時設定步數或 token 預算,超限即止;困難任務交給強模型,機械任務交給低成本模型;併發數設定上限,避免幾十個 Agent 同時耗盡 API 配額;當併發數達到上限,更緊急的任務到來時,打斷執行中的子 Agent,這就是搶佔。
與傳統作業系統的排程器相比,管理者 Agent 的顯著優勢在於它具備推理能力。因此,管理者 Agent 可以啟動多個子 Agent 並行探索一個問題,並根據它們的進展,決定給哪些 Agent 分配更多資源,或者終止哪些看起來誤入歧途的 Agent,就像公司內部賽馬一樣。
資源和排程領域的實踐還遠不如作業系統排程成熟,但它決定了多 Agent 系統的成本上限,應當在架構設計階段就予以考慮。
產物交換(資料平面)與訊息傳遞、狀態查詢、執行終止、資源排程(控制平面)共同支撐起不共享上下文的多 Agent 系統。根據 Agent 之間的協作關係和控制流特徵,不共享上下文的協作可以分為三種主要架構:對等協作模式、管理者模式、去中心化模式,分別適用於不同型別的任務。
10.4.3對等協作模式:相互制衡與迭代改進
對等協作通常涉及 2-3 個平等身分的 Agent,透過多輪迭代互相提供回饋。它的潛在價值在於引入獨立視角和認知多樣性,但「多個例項」不等於「多種思路」。當模型、上下文和鷹架高度相似時,不同 Agent 往往會做出相同選擇,使局部錯誤演變為系統性故障。要獲得真正的多樣性,需要主動區分模型、上下文、工具、可見證據或職責,並讓各 Agent 先獨立判斷、再彙總結果。[4:1]
相比管理者和去中心化模式,對等協作的實作複雜度更低:只需定義好兩個 Agent 的角色、通訊機制和迭代終止條件,就可以跑起來。
Loop 工程
對等協作最經典的用途,是解決 Agent 實踐中極其常見的一類失敗:過早終止——活幹到一半就停。它有三種典型形態,下面用 Coding Agent 和筆者團隊打造的 Pine AI(引言介紹過的替使用者打電話與商家、電信業者交涉辦事的 Agent)各舉幾例。一是偷懶式假完成:只做了一部分就宣稱全部做完——Coding Agent 寫完程式碼,測試沒跑、部署沒試,就報告「任務完成」;使用者交給 Pine AI 兩件事,它辦完第一件就把第二件忘了,徑直彙報「都辦好了」。二是過早放棄:一條路走不通就宣佈整件事辦不成——Pine AI 聯絡商家本有打電話、填表單、發郵件等多種途徑,打了一個電話被拒絕,就直接告訴使用者「這事辦不了」,其實換個管道再試很可能就成了。三是假成功:Agent 以為辦成了,實際閉環沒走完——電話裡對方口頭同意退款,但使用者還需要在手機 App 上確認一步,Agent 卻報告「已辦妥」,使用者不知道還有後續動作,退款實際沒有完成。三種形態指向同一個根源:在驗證之前,「完成」只是模型的一句宣稱,不是證明。
把宣稱變成證明,正是 Loop 工程(Loop Engineering)的課題:設計一個讓 Agent 持續運轉的迴圈——發現下一件該做的事、執行、驗證、記錄進度——由驗證器而不是模型自己來判定「是否真的可以停」,人的角色則從「給 Agent 寫提示詞的操作者」變成「設計迴圈的工程師」。這個名詞在 2026 年 6 月由 Addy Osmani 總結提出[6],Claude Code 負責人 Boris Cherny 的說法更直白:「我已經不再直接 prompt Claude 了,我的工作是寫 loop。」業界在這場討論中形成的核心共識是:迴圈的瓶頸在驗證器,而不在模型。驗證不可靠,迴圈轉得再快,也只是把劣質產出更快地標記為完成。也正如引言所說,實踐在前、命名在後:在這個名詞流行之前,包括 Pine AI 在內的頂尖 Agent 團隊早已在用「迴圈加驗證」解決過早終止問題。而驗證最有效的組織方式,正是下面要講的提議者-審核者範式。
具體框架:LoopX。 LoopX 把迴圈從模型的提示詞和聊天歷史中抽離出來,放進一個與 Agent 執行環境無關的持久控制面:目標與邊界說明 「為什麼做」,門禁和待辦決定 「現在能做什麼」,證據與配額決定 「是否繼續」,移交則讓下一輪或另一個 Agent 接著工作:
LoopX 決策 → Agent 執行 → 獨立驗證器證明 → LoopX 提交
其中,Agent 仍負責推理、呼叫工具和生成候選成果;LoopX 不替代 Agent 執行環境,而是管理跨輪次的連續性。只有通過獨立驗證的結果才能寫入持久進度並消耗配額;驗證失敗會進入修復或重規劃,人工門禁、等待狀態和預算上限則在執行前阻止迴圈繼續。這個邊界把 Loop 工程的原則變成了可檢查的系統不變數:模型可以提出 「完成」,但不能批准自己的 「完成」。 LoopX v0.4.0 的受控 Turn 路徑仍標為實驗性,因此這裡把它作為 「迴圈 + 驗證 + 終止條件」 的具體框架,而不是一般任務品質提升的證據。[7]
具體框架:LongHorizon-Harness。 LongHorizon-Harness 與 LoopX 都是 Loop 工程的具體實作,但關注的方向不同。LoopX 面向長期 Agent 工作的持久控制面;LongHorizon-Harness 則從多模態 Computer Use 出發,處理同一任務跨越 GUI、CLI、多個桌面應用和多次上下文重新整理的連續執行問題。
LongHorizon-Harness 將長程執行重新表述為任務狀態管理,並把自己的迴圈實作為 Manage–Execute–Audit(MEA):Manager 根據原始目標、已核實進展、失敗證據和剩餘工作生成下一項有界子任務;Executor 在全新上下文中透過 GUI 或 CLI 改變環境;Auditor 再以唯讀方式檢查真實結果。只有稽核通過的內容才能進入下一輪任務狀態,失敗則被保留為恢復和重規劃的依據。它透過適配層重用 Claude Code、Codex CLI 等執行後端,而不改寫後端內部的 Agent loop。[8]
這一方向的價值,在於把任務連續性從不斷增長的執行歷史中分離出來:上下文可以重新整理,介面操作也可能失敗,但下一輪仍能從最近一次核實的狀態繼續。論文在保持底層模型與 Claude Code 執行後端相同、只改變外層 loop 的對照中,報告 WeaveBench PassRate 從 51.8% 提升到 80.7%,OSWorld 2.0 二元完成率從 2.8% 提升到 8.3%,Terminal-Bench 2.1 成功率從 69.7% 提升到 77.2%。代價也不是固定的:前兩個基準分別消耗了基線 2.3 倍的總 token 和 3.6 倍的輸出 token,Terminal-Bench 2.1 則減少了 24%。在實際部署中,還需要處理外部環境或使用者要求變化造成的舊狀態失效,並用輪數、時間和費用預算防止恢復迴圈無限執行。
公開軌跡與實驗重現。 專案網站提供了 WeaveBench、OSWorld 2.0 和 Terminal-Bench 2.1 的數百條執行軌跡,可以直接檢視執行過程和不同角色的記錄。以 WeaveBench 的 WEB_task_16_webrtc_simulcast_layer_audit 為例,可以對照使用同一底層模型的基線軌跡與 MEA 軌跡:前者在 Wireshark 互動卡住後反覆嘗試,得分 0.59;後者把失敗和未滿足的證據項寫回任務狀態,後續輪次只處理缺口,得分 0.92。這個案例用於展示「失敗如何變成下一輪輸入」,不能代替總體統計;完整實驗的環境、參數和啟動指令碼見固定版本的 eval/ 目錄。
提議者-審核者範式
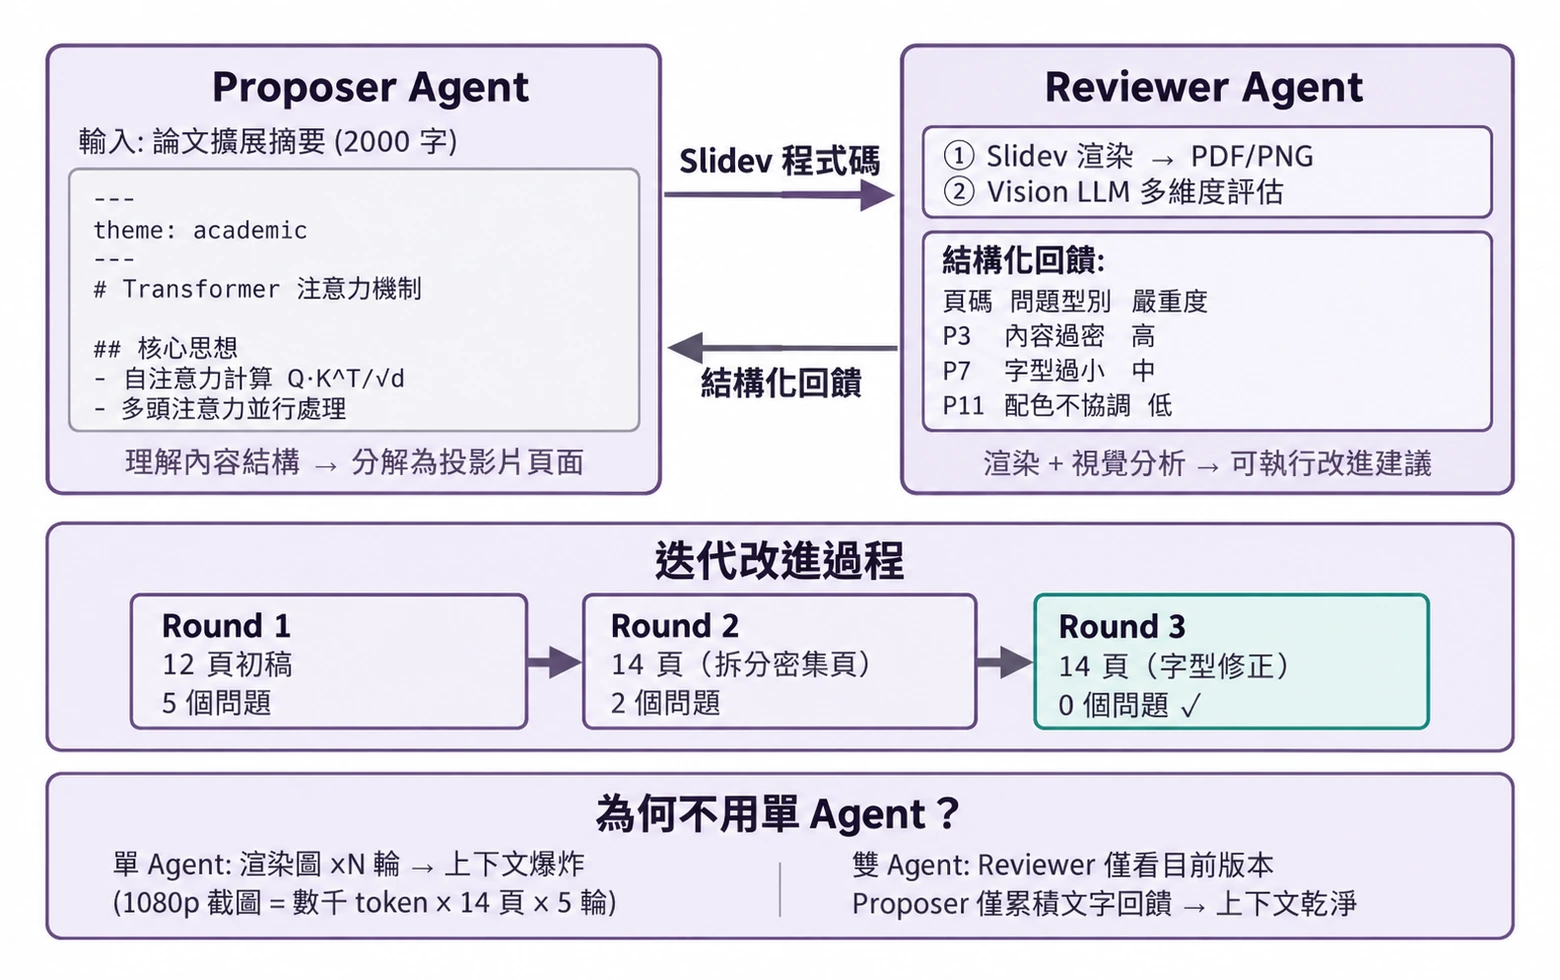
提議者-審核者是最經典的對等協作範式。第五章已經在 PPT 生成、影片編輯和日誌視覺化三個實驗中詳細介紹了這一範式的設計原則和實戰應用:Proposer Agent 負責生成程式碼,Reviewer Agent 渲染執行結果並用 Vision LLM 評估品質、給出結構化改進建議,兩者反覆迭代直到效果達標。
這一範式同樣適用於安全審查(提議者生成操作方案,審核者檢查合規性和潛在風險)、內容審核(提議者起草回覆,審核者檢查業務規則和用語規範)、程式碼審核(提議者編寫程式碼,審核者檢查安全性和最佳實踐)等場景。
為什麼不能讓一個 Agent 自己生成再自己審查? 這正是前面「多 Agent 何時真正優於單 Agent」一節那條判據的具體體現——審查若不引入新資訊,就只是「讓模型再想一遍」。相關研究對此給出了明確的答案。Huang 等人在 ICLR 2024 論文《Large Language Models Cannot Self-Correct Reasoning Yet》中發現:讓 GPT-4 在沒有外部回饋的情況下審查並修正自己的回答,準確率反而下降——模型把正確答案改錯的次數比把錯誤答案改對的次數更多。
提議者—審核者迴圈的最小不變數是:審核者讀取獨立證據,而不是只複述提議者的解釋;退回時必須給出可定位的修復條件:
candidate = proposer(task, constraints)
evidence = execute_or_render(candidate)       # tests, state, screenshot, facts
review = independent_reviewer(candidate, evidence)

while review.veto and budget_remaining:
    candidate = proposer.repair(candidate, review.findings)
    evidence = execute_or_render(candidate)
    review = independent_reviewer(candidate, evidence)

if review.pass:
    publish(candidate, evidence, review)
else:
    escalate_or_reject(review)
審核者不能修改測試、證據採集器或發布門檻;否則「獨立驗證」會退化成自我批准。
2024 年發表在 TACL 期刊上的綜述論文《When Can LLMs Actually Correct Their Own Mistakes?》(arXiv:2406.01297)進一步確認了這一結論:除非提供可靠的外部回饋(如測試案例的執行結果、外部工具的驗證輸出),否則純粹依賴模型自身的「自我糾正」幾乎不起作用。
ICLR 2024 的 CRITIC 論文提供了一個直觀的對比實驗:讓模型使用外部工具(搜尋引擎、Python 直譯器)驗證自己的回答,效果顯著提升;一旦移除工具驗證、只保留模型的自我評估,大部分提升就消失了。回到第五章的 PPT 生成實驗也是同理——審核者的價值不在於「用同一個模型再看一遍程式碼」,而在於它渲染了 PPT 並截取了畫面——截圖承載著提議者生成程式碼時完全無法獲得的視覺資訊;程式碼生成場景中執行測試產生的通過/失敗結果,同樣是編寫程式碼時並不存在的新訊號。
Anthropic 2026 年的長程應用開發實驗把這一思路實作為規劃者–生成者–評估者三 Agent 架構:規劃者把使用者的需求展開為產品規格,生成者與評估者先約定每輪的完成標準,再由生成者實作,然後評估者使用 Playwright 操作真實應用並提交缺陷報告。Agent 之間透過檔案交接狀態。實驗說明,當任務超出目前模型單獨可靠完成的範圍時,帶外部證據的獨立審核可以用顯著更高的成本換取更好的開發品質。[9]
辯論模式
多個 Agent 各持不同立場,透過對抗性對話深入探索問題空間。比如評估一個技術方案時,Agent A 扮演「支持者」列舉方案優勢和機會,Agent B 扮演「反對者」指出風險和局限,每輪辯論都針對對方的論點提出反駁或補充。單一 Agent 分析時,模型往往傾向某個觀點而忽視反面證據;辯論模式則透過制度化的對抗,確保正反兩面都得到充分論證,幫助決策者做出更平衡的判斷。
不過,辯論模式的實際效果在學術界仍有爭議。2026 年 Tran 與 Kiela 的研究 [10] 在多跳推理任務上對比了單 Agent 與五種多 Agent 架構(順序、辯論、整合、並行角色、子任務並行),發現當思考 token 預算被嚴格控制為相同時,單 Agent 的表現與多 Agent 持平甚至更好。研究者基於資訊理論中的資料處理不等式給出了解釋:辯論中的多個 Agent 處理的是完全相同的文字資訊,Agent 之間每一次序列傳遞中間結論都只可能丟失資訊、不可能憑空創造資訊。辯論模式在一些學術論文中的收益很可能來源於多個 Agent 消耗了更多的總計算量。不過,它並不否定另一類做法——對同一問題多次獨立取樣再聚合(如自一致性、多數投票),或利用生成與驗證的難度不對稱(寫出答案難、檢驗答案易)來做生成-驗證分工。
頭腦風暴模式
多個 Agent 獨立生成創意,然後相互分享、彼此啟發。比如在產品創新任務中,Agent 1 提出「增加社交分享功能」,Agent 2 受啟發提出「不僅分享到社交網路,還可以生成個人化分享海報」,Agent 3 綜合前兩者提出「使用者自訂海報範本並形成範本市場」。不同 Agent 擁有不同的「思維偏好」(透過不同提示詞或模型實作),透過相互激發來探索更廣闊的解空間,找到單一 Agent 難以想到的創意組合。
專家小組模式
多個 Agent 各自代表一個專業領域的視角,共同討論跨學科問題。比如評估新產品的可行性時,工程師 Agent 從技術角度分析實作難度,產品 Agent 從使用者體驗角度評估市場吸引力,營運 Agent 從成本和資源角度分析商業可行性。這些 Agent 之間不是對抗關係,而是互補關係,共同拼出問題的全貌,識別跨領域的約束和機會。
10.4.4管理者模式:中心化協調
當任務涉及大量子任務、需要動態排程或子任務之間存在複雜依賴時,對等協作就力不從心了,需要引入管理者模式。Manager Agent 的職責就像一個專案經理:先理解整體任務,再拆解為可分配的子任務,選擇合適的 Agent 去執行,追蹤進度並處理異常(重試、換 Agent、調整計畫),最後把各 Agent 的輸出整合為最終結果。
從系統設計角度看,管理者模式把每個專門 Agent 建模為 Manager 可呼叫的工具。Manager 的工具集中不僅有傳統的外部工具(如搜尋、檔案操作),還包含其他 Agent 的呼叫介面。Manager 透過工具呼叫機制啟動相應 Agent,傳遞任務參數和必要上下文,等待完成後接收返回結果。從 Manager 的視角看,呼叫一個 Agent 和呼叫一個普通工具沒有本質區別。這種統一抽象賦予了管理者模式良好的可擴展性。新增能力只需開發對應 Agent 並註冊為工具,Manager 的核心邏輯無需修改。同時它天然支援異構性,不同 Agent 可以用不同的模型、提示詞、工具集,甚至執行在不同的硬體環境上。
但管理者模式也有固有的挑戰。Manager 成為系統的單點瓶頸——它必須理解所有子任務的性質,選擇正確的 Agent,準確傳遞上下文,任何決策偏差都會影響整體流程。此外,Manager 需要維護整個任務的全域性上下文,隨著任務推進和 Agent 呼叫增多,上下文可能快速膨脹。因此需要特別注意 Manager 的提示詞品質、上下文管理策略和合理的任務分解粒度。
2025 年的 Plan-and-Act 論文 [11] 對此做了實證分析:在 Planner-Executor 雙 Agent 架構中,弱規劃者是整個系統最關鍵的瓶頸。當 Planner 的規劃品質足夠高時,即使 Executor 比較簡單也能取得好結果;反之,如果 Planner 的任務分解有誤,後續所有 Executor 的工作都建立在錯誤的前提上。該研究在 WebArena-Lite 基準上取得了 57.58% 的成功率,核心貢獻正是改善了 Planner 的規劃能力,而非 Executor 的執行能力。這一發現的啟示是:應當將最強的模型和最精心設計的提示詞分配給 Manager(規劃者),而不是將資源平均分配給所有 Agent。
並行管理器還要定義「第一個已驗證成功」而不是「第一個聲稱成功」的結算點:
workers = launch_independent_workers(subtasks)
while workers.any_running:
    event = next_event()
    if event.type == RESULT:
        if verify(event.artifact, hidden_checks):
            if not settle_once(event):       # atomically claim the winner
                continue
            broadcast_cancel(to = workers - {event.worker_id})
            await_all_ack_or_timeout()
            return assemble(event.artifact, evidence = event.evidence)
        else:
            record_failure(event)
return summarize_failures(workers)
settle_once 必須是冪等的(通常由鎖或交易保護),否則兩個幾乎同時到達的成功事件會觸發兩次彙總。
順序協調形態。
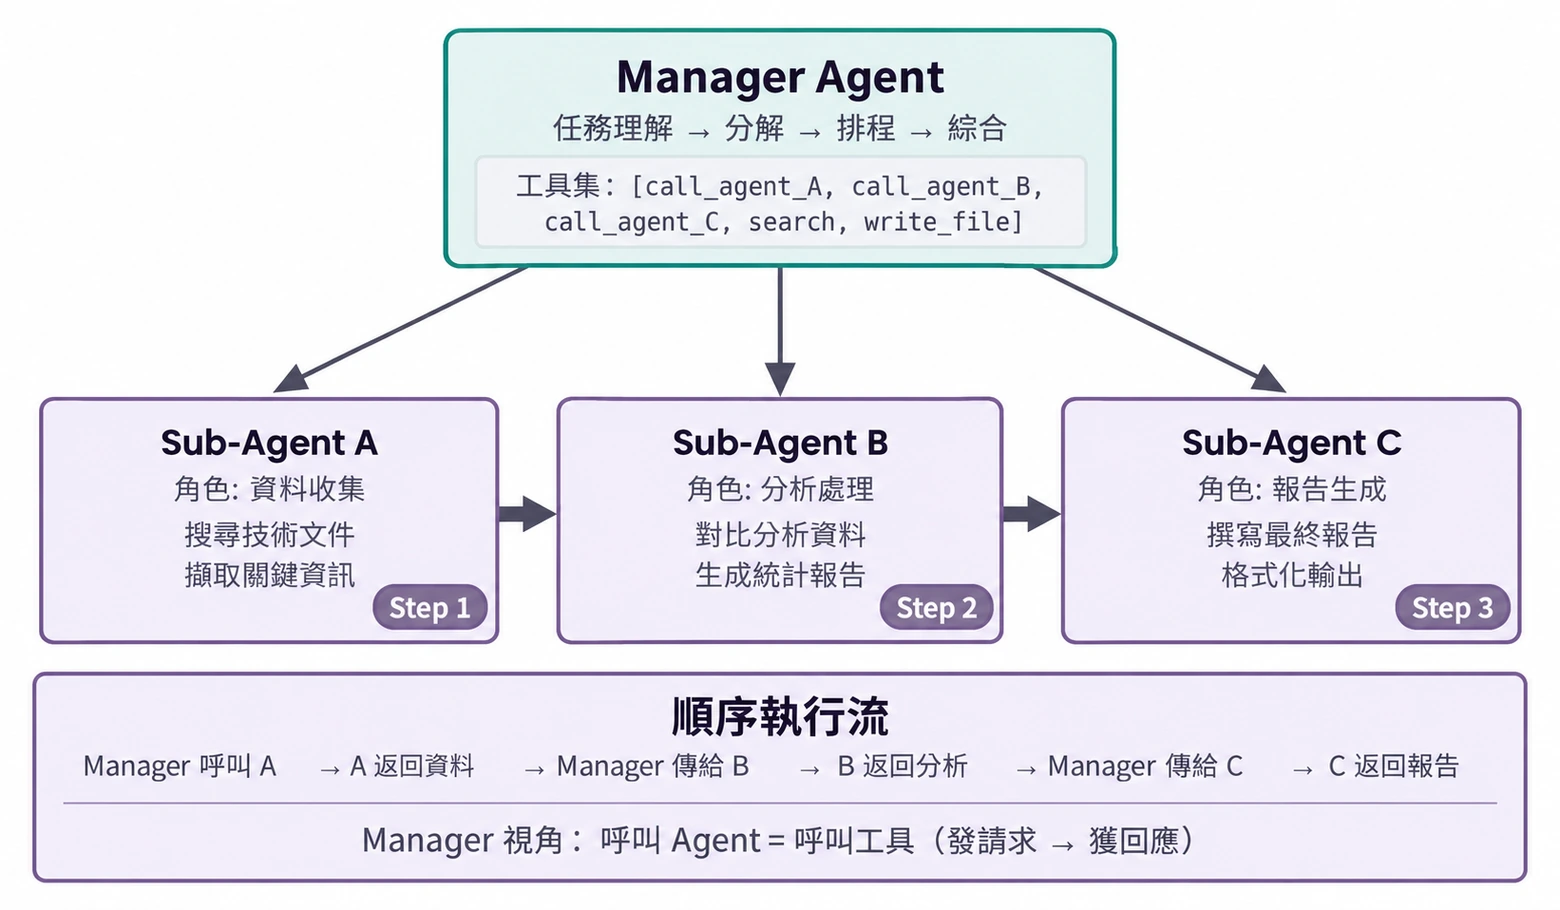
Manager 按順序依次呼叫專門 Agent,每個 Agent 完成後返回結果,Manager 再決定下一步。控制流是線性的,簡單明瞭,適合子任務之間有清晰先後依賴的場景。
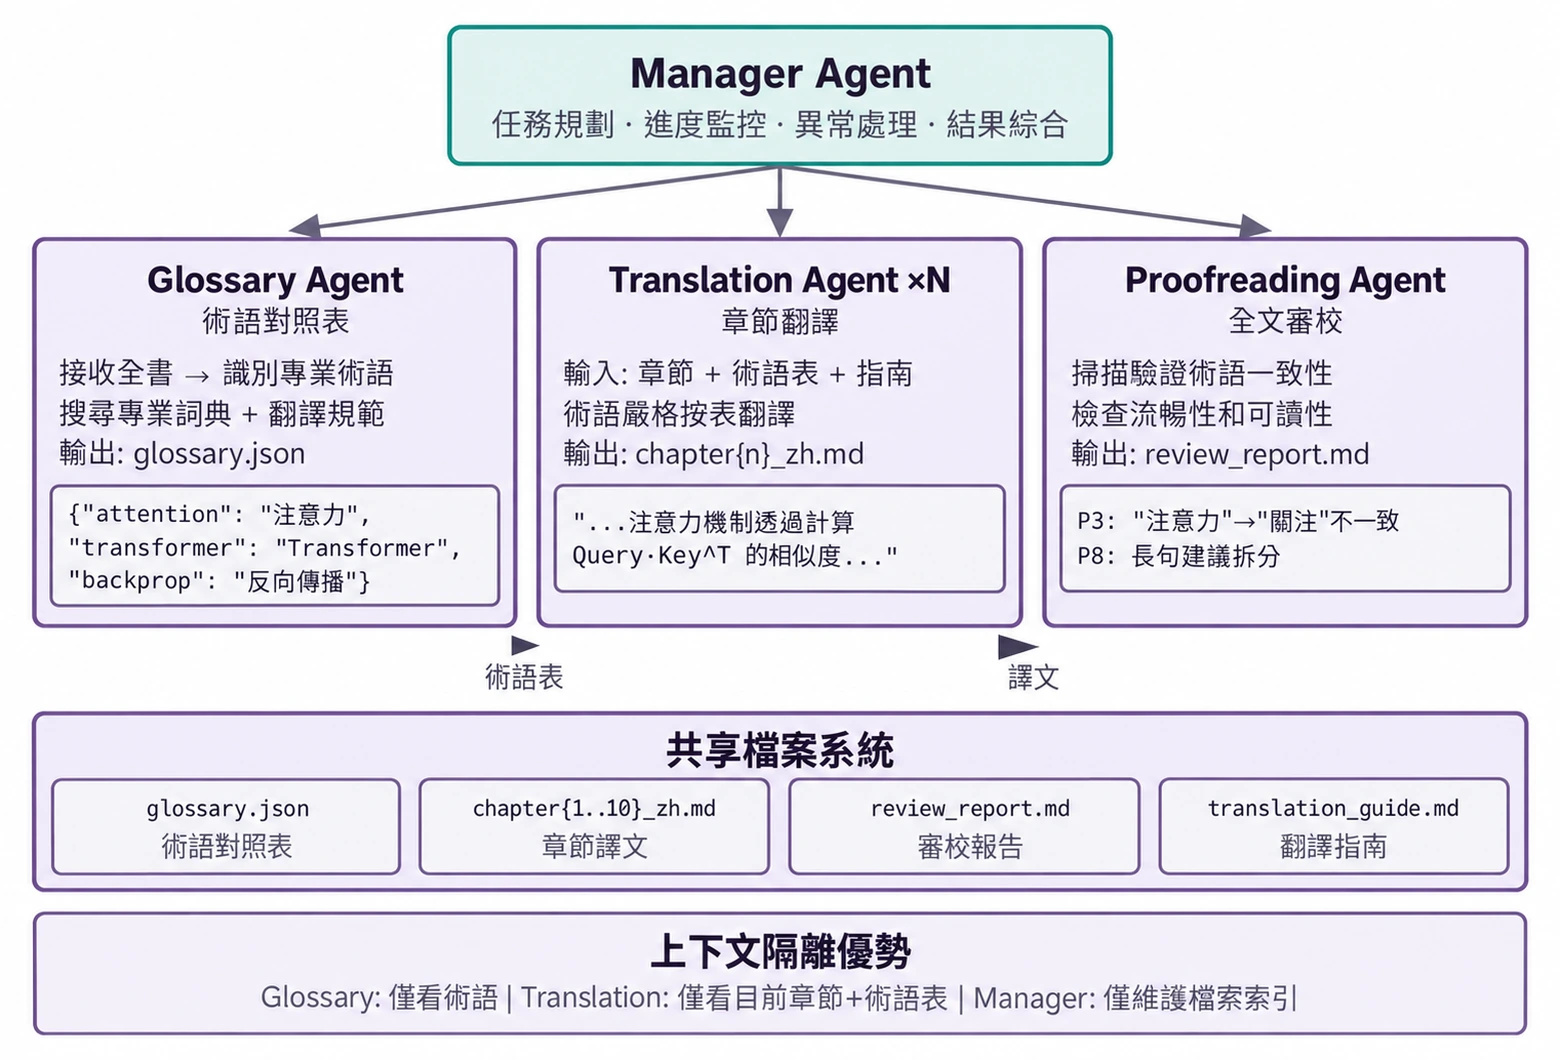
實驗 10-2 ★★:書籍翻譯 Agent
書籍翻譯是一項典型的、需要多 Agent 協作的複雜任務。翻譯一本技術書籍,不僅僅是把文字從一種語言轉換為另一種語言,更需要保證專業術語全書一致、語境準確、整體閱讀流暢。比如翻譯一本大型語言模型相關的英文書,大量術語會反覆出現,可能有多種約定俗成的說法,必須全書統一,例如第一章把 agent 譯為「智慧體」,後面就不能改成「代理」。
如果用單一 Agent 來做,會面臨嚴重的上下文問題。隨著 Agent 逐章處理內容,上下文不斷累積:全書術語表、已翻譯章節、目前段落、翻譯思考過程、工具呼叫結果。一本幾百頁的技術書籍加上翻譯中間產物,很容易超出上下文視窗。更嚴重的是,在過長的上下文中 Agent 容易「迷失」——忘記之前的術語約定,到第九章用了與第二章不一致的譯法;審校階段重複檢查浪費資源;甚至因注意力分散而產生幻覺,「記起」實際上並不存在的術語規則。
管理者模式透過任務分解和責任分離來解決這些問題:
- Glossary Agent(術語對照表 Agent):接收全書內容,識別重複出現的專業術語,搜尋專業詞典和翻譯規範,生成結構化術語對照表(JSON/CSV 格式,包含英文術語、中文翻譯、詞性、使用語境)。完成後寫入共享檔案系統,Agent 即可銷燬釋放資源
- Translation Agent(章節翻譯 Agent):接收目前章節、術語對照表和翻譯指南(目標讀者水平、語言風格),翻譯為流暢的中文。遇到對照表中的術語嚴格使用規定譯法,遇到新術語則推斷翻譯並標記為待審查。每個例項在獨立上下文中工作,互不干擾。譯文寫入檔案系統(如
chapter1_zh.md)。Manager 可並行或序列啟動多個例項 - Proofreading Agent(全文審校 Agent):接收所有譯文和術語表,執行一致性檢查——逐一驗證術語翻譯是否統一、識別前後不一致之處、檢查整體流暢性和可讀性。生成審校報告寫入檔案系統
- Manager Agent:上下文中主要儲存任務描述、執行計畫、各 Agent 的呼叫記錄和進度狀態。不儲存完整翻譯內容(這些存在檔案系統中),只維護檔案索引。根據審校報告,Manager 可以把特定章節發回 Translation Agent 修訂
在這個架構中,Manager Agent 的上下文始終保持在可管理的範圍內:它只需要知道任務的整體描述和目標、各階段的執行計畫、每個 Agent 的呼叫記錄和返回結果、以及目前的進度狀態,而不需要裝下每章的完整翻譯內容。
關鍵優勢在於上下文隔離:Glossary Agent 只看術語擷取所需的內容,Translation Agent 只看目前章節和術語表,Proofreading Agent 雖然需要存取全文但只關注一致性檢查。每個 Agent 都在一個精簡、專注的上下文中工作,不僅效率更高,出錯的可能性也更低——Agent 不會因為資訊過載而分散注意力。
實驗要求:
- 選擇一本圖文並茂、包含程式碼的技術書籍作為翻譯物件
- 實作 Manager、Glossary、Translation、Proofreading 四種 Agent
- 記錄每個 Agent 的上下文消耗,驗證管理者模式控制上下文膨脹的有效性
- 對比單 Agent vs 管理者模式在翻譯品質、執行效率、資源消耗方面的差異
並行協調形態。
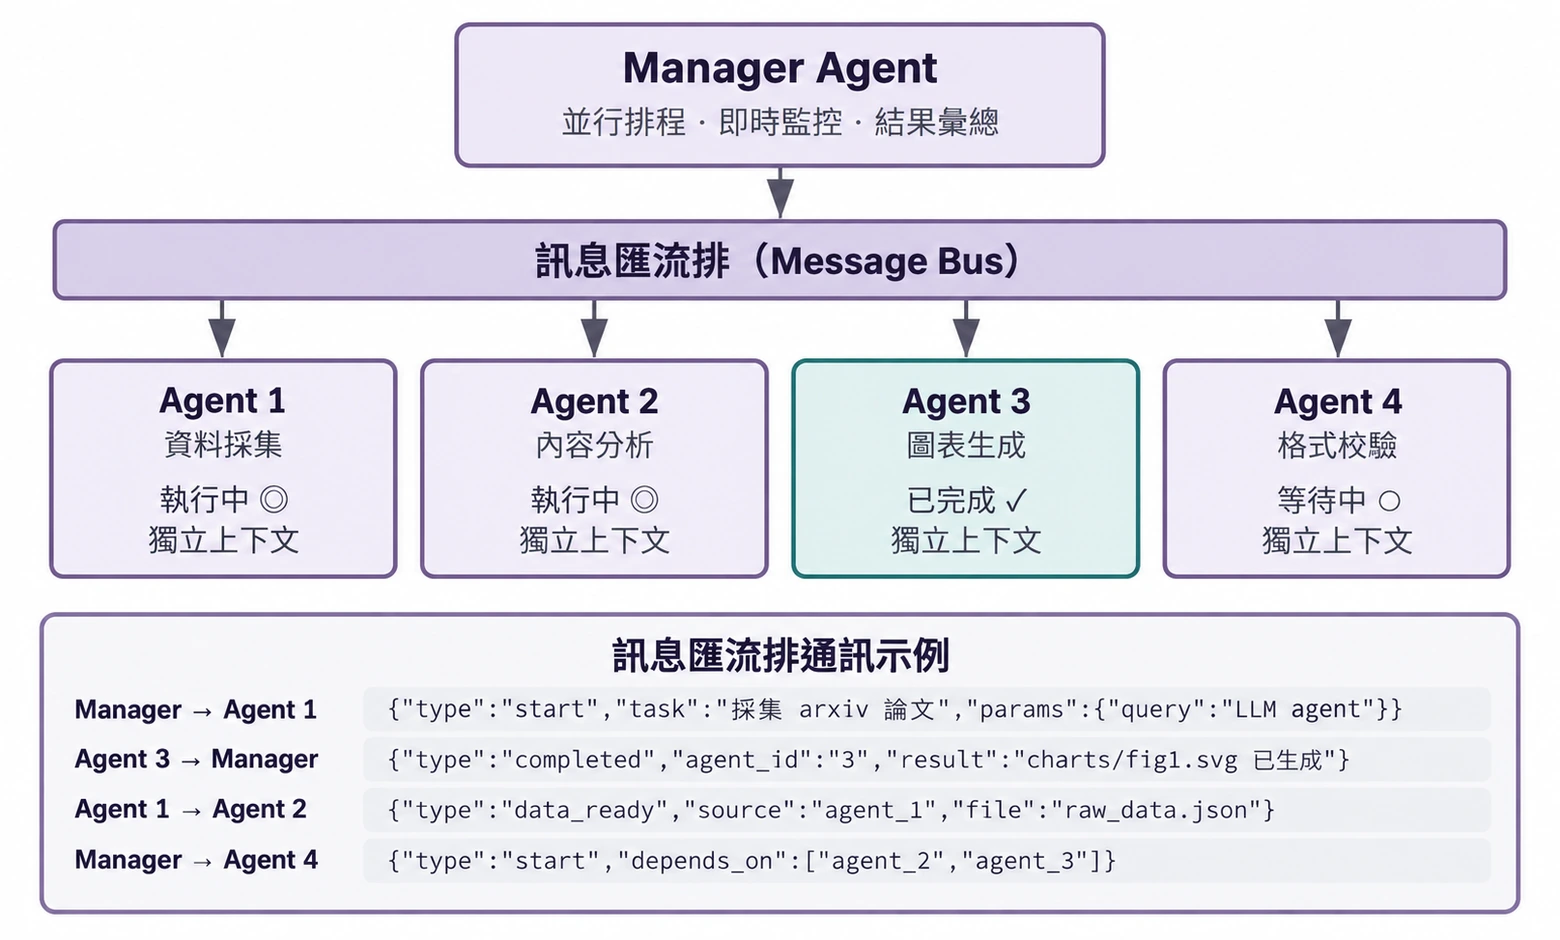
當多個子任務可以並行執行時,順序模式就顯得效率低下了。並行協調讓多個 Agent 同時工作,大幅提升吞吐量。Manager Agent 不僅要規劃並行任務,還要即時監控所有執行中的 Agent,協調通訊,在 Agent 成功或失敗時做出全域性決策。這通常需要訊息匯流排(Message Bus)作為基礎設施——可以把它理解為一個 「公共公告板」,Agent 可以往上面貼訊息(發布),也可以關注自己感興趣的訊息型別(訂閱),實作非同步通訊、互不阻塞。
靈臺(Lingtai):管理者模式的一個產品化例項。 靈臺是一個本地執行、以檔案為本的長期 Agent 居所[12],它的三種角色是本節概念的完整實作:
- 主器靈(main agent)是與使用者對話的常駐中樞,掌管計畫與記憶,並把工作派生給其他角色,這正是 Manager Agent 的位置;
- 分神(daemon)是為一件嘈雜而有界的工作分出的短時並行工作者,完成後即棄,只把結論帶回主器靈,這正是 「子 Agent 返回結構化摘要而非全量軌跡」 與並行協調形態的產品化;
- 分身(avatar)則是擁有自己的記憶、信箱與職責的持久專門化隊友,用於值得跨多次工作階段保留的專業分工。
它的其餘設計也與前文一一呼應:知識是每個器靈私有的持久記憶檔案,技能是所有器靈共享的 Markdown 手冊;上下文視窗將滿時,器靈會 「凝蛻」(molt),給自己寫一份總結,帶著持久記憶在乾淨的上下文中繼續工作(對應第二章的上下文壓縮)。底層模型可以替換而器靈猶在。身分、記憶與能力都以普通檔案的形式存放在專案目錄中,即 「器靈即其檔案」。
實驗 10-3 ★★★:自主編排的電話 + 電腦 Agent
前置要求:本實驗綜合運用第六章的 Computer Use 和語音 Agent 技術。
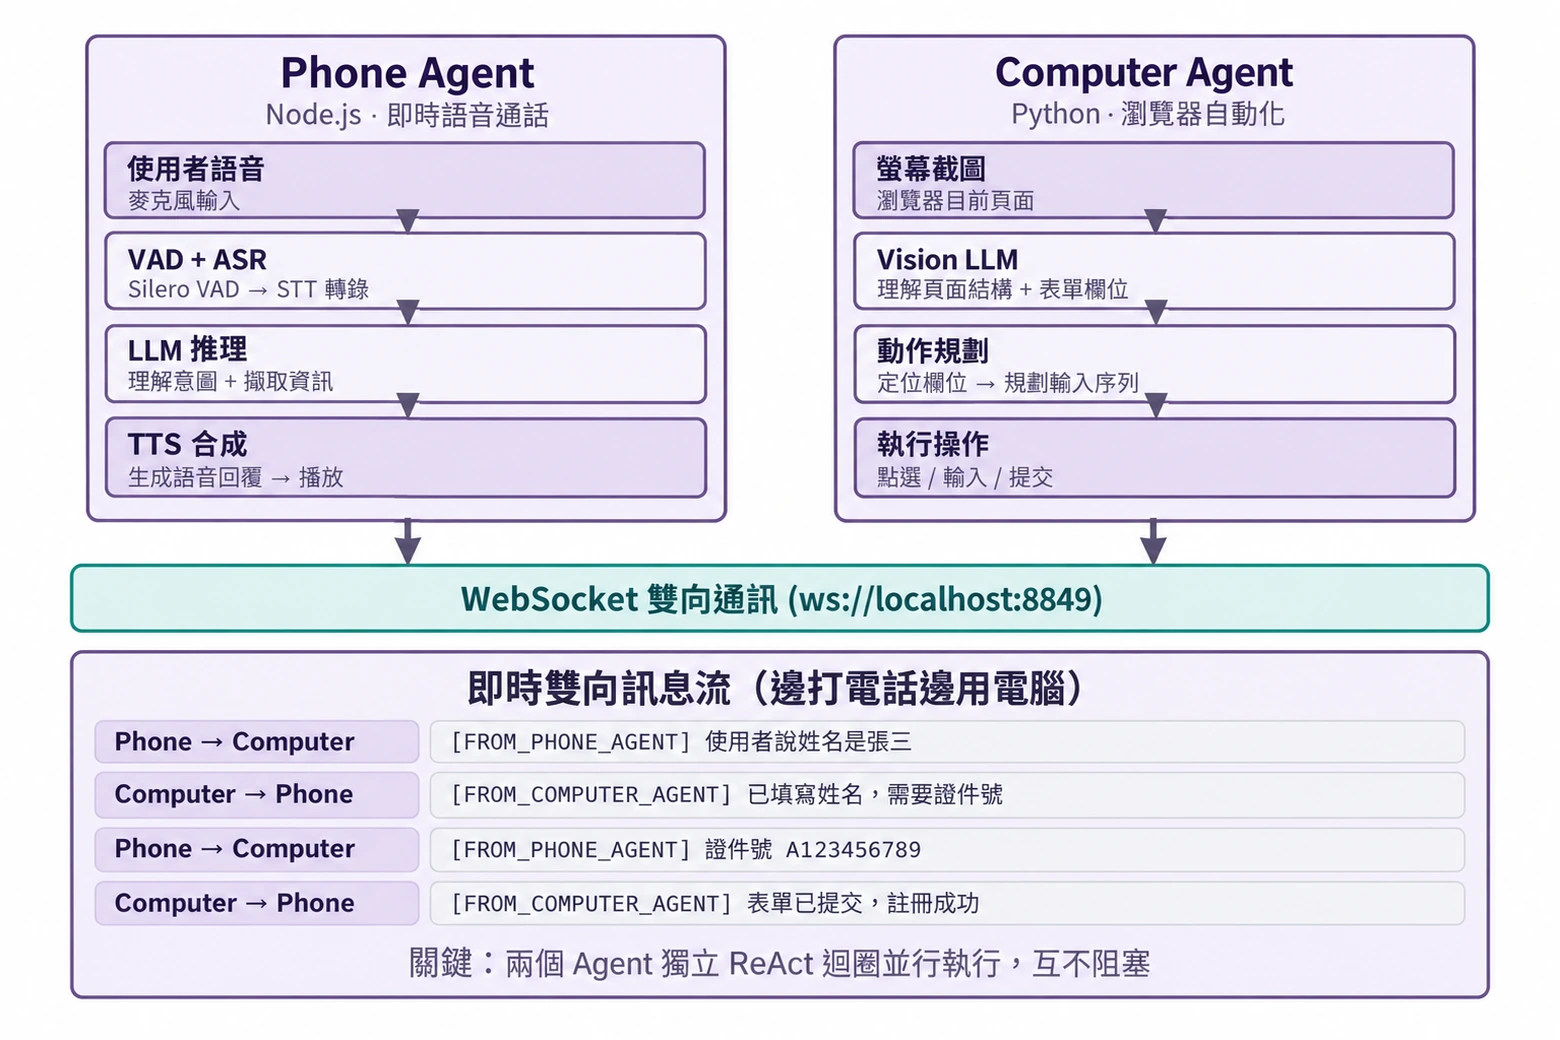
任務場景:使用者只給出一個網站 URL,請 Agent 填寫複雜的註冊或航班預訂表單。Computer Agent 先開啟頁面並識別欄位;姓名、證件號、聯絡方式、地址和偏好等資訊不在目前上下文中,需要向使用者收集。
系統架構:Computer Agent 負責瀏覽器操作,也是本實驗的編排者;Phone Agent 負責 ASR、LLM、TTS 和即時對話。兩者透過點對點工具或訊息匯流排交換結構化訊息(傳送者、接收者、型別、內容)。不需要額外的 Manager 行程:Computer Agent 可以像呼叫工具一樣呼叫 Phone Agent。
直接讓使用者在聊天框中逐項打字會比較慢,也容易漏項或輸錯格式;電話 Agent 可以連續詢問、確認和重問,把自然語言回答轉換成結構化欄位。
兩種執行模式:
- 固定模式(併發基線):預先啟動兩個 Agent,驗證獨立 ReAct 迴圈、雙向通訊和真正並行。
- 自主模式(主實驗):只啟動 Computer Agent。它根據頁面、已知資訊和任務需要,自主決定是否呼叫
initiate_phone_call_agent(purpose, required_info);不要用「欄位數量超過閾值」的 Python 規則代替模型決策。呼叫後,系統把任務目的、待收集欄位及格式約束作為獨立上下文交給 Phone Agent,再沿用固定模式的通訊和並行機制。
並行與閉環:Phone Agent 透過 WebRTC 逐項提問、抽取並校驗回答;Computer Agent 同時截圖、理解頁面並填寫欄位。每收到一個有效值就傳送 info_collected,Phone Agent 不等待網頁填寫完成便詢問下一項;Computer Agent 回饋 fill_error 或頁面狀態,Phone Agent 據此調整話術。格式錯誤傳送 format_invalid 並重新詢問,超過重試次數或頁面異常則安全暫停。資訊收集完成後傳送 task_completed,Computer Agent 通過校驗後提交表單。異常時取消仍在執行的對端,關閉瀏覽器、音訊軌道和通話;真人語音須明確同意,提交須明確授權。
實驗要求:
- 實作兩個獨立 Agent 及高效的雙向結構化通訊;
- 在固定模式和自主模式下證明「問下一個」和「填上一個」真正重疊;
- 實作欄位格式校驗、重問、頁面錯誤回饋、逾時和資源清理;
- 記錄訊息時序、自主啟動決策、延遲、成功率和資源消耗,並比較兩種模式。
實驗 10-4 ★★★:同時從多個網站蒐集資訊的 Agent
前置要求:建議先了解第六章的事件驅動與中斷機制。
本實驗探索多 Agent 並行執行在資訊收集場景中的應用。與實驗 10-3 的兩個異構 Agent 協作不同,本實驗關注的是多個同構 Agent 的並行搜尋,以及如何透過中心協調實作高效的任務完成和資源最佳化。
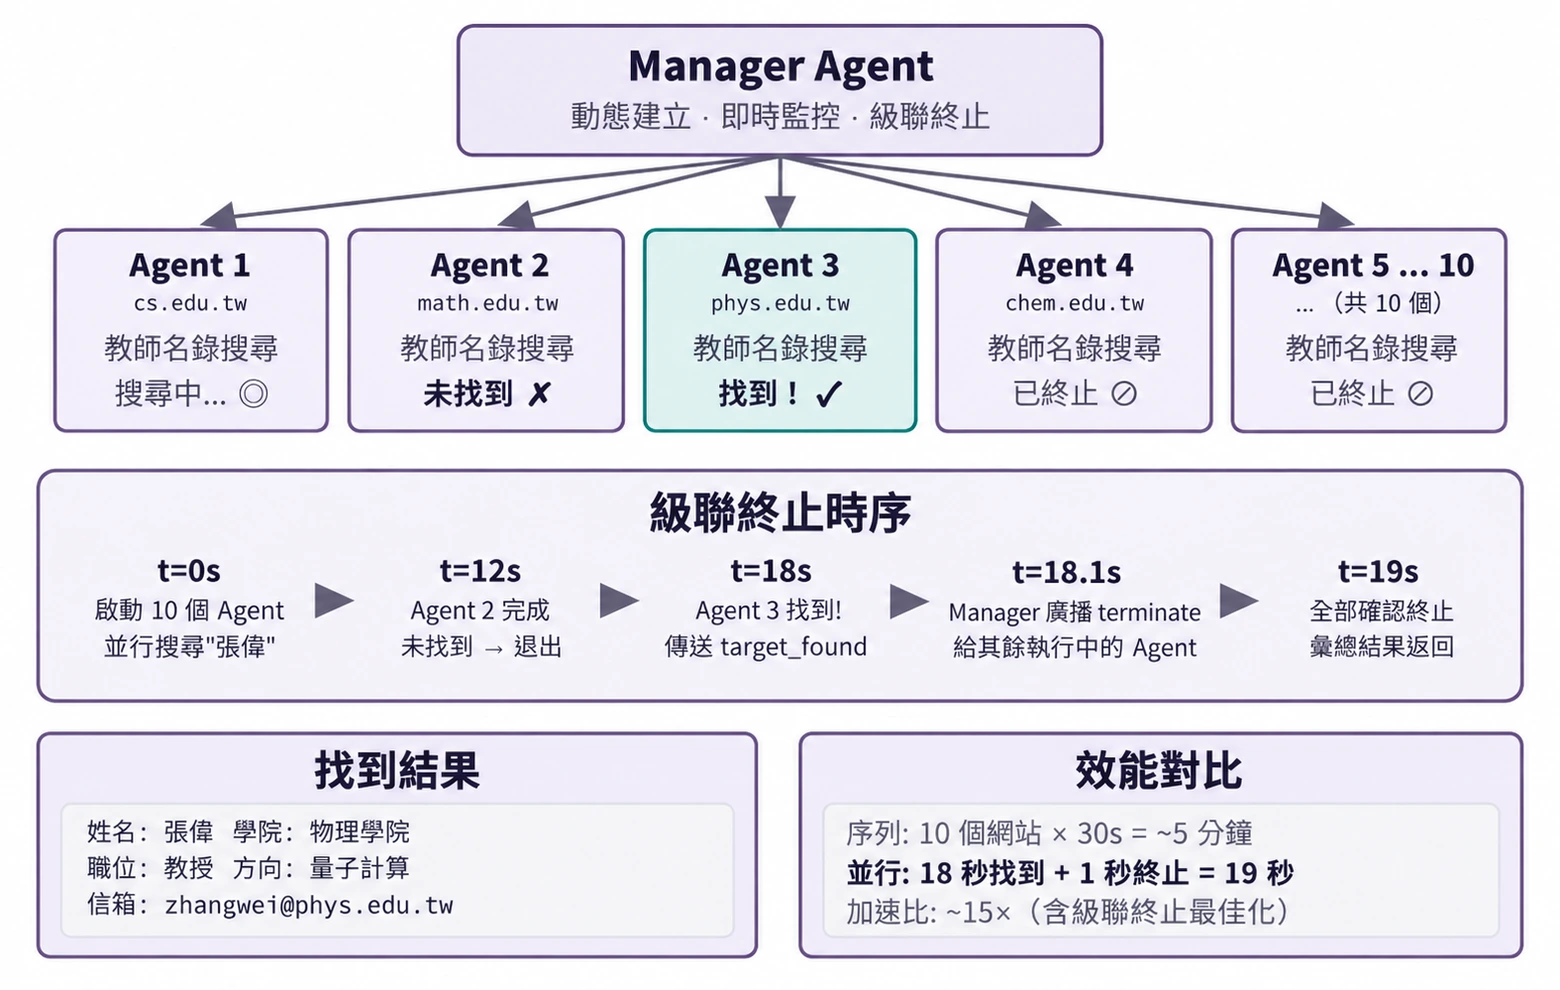
問題:給定一所大學的多個學院網站,要求在各學院的教師名錄頁面中查詢指定教師(如「張偉」),找到後返回其所在學院、職位、研究方向等資訊。
核心挑戰:
1. 並行啟動:Manager Agent 根據任務需求動態建立 10 個 Computer Use Agent 例項,每個例項對應一個學院網站。每個例項應是獨立行程或執行緒,擁有獨立的瀏覽器工作階段,能併發執行且互不阻塞。啟動時傳遞:目標網站 URL、要搜尋的教師姓名、任務識別符號(用於訊息路由)。
2. 即時監控:每個 Agent 在執行過程中定期傳送狀態更新(「正在載入網站」「正在解析教師名錄」「未找到目標,任務完成」「找到匹配,詳細資訊如下」)。Manager Agent 透過訊息匯流排接收這些更新,維護一張任務狀態表,即時掌握哪些 Agent 還在執行、哪些已完成、哪些遇到了錯誤。
3. 級聯終止:假設負責電腦學院的 Agent 找到了目標教師,它傳送 {"type": "target_found", "agent_id": "agent_3", "data": {...}}。Manager Agent 收到後立即向所有其他仍在執行的 Agent 傳送 {"type": "terminate", "reason": "target_found_by_agent_3"},每個收到終止訊息的 Agent 優雅停止並傳送確認。Manager Agent 等待所有確認(或逾時)後彙總結果。要求:Agent 能隨時回應終止訊號(類似第六章的中斷機制),終止必須優雅——不留懸掛行程或未關閉的資源;同時需處理競態條件(Race Condition)。
概念補充:什麼是競態條件? 假設 Agent A 和 Agent B 幾乎在同一毫秒內各自找到了目標教師,它們同時向 Manager Agent 報告「我找到了!」。如果 Manager Agent 處理不當——比如收到 A 的報告後開始彙總結果,但緊接著又收到 B 的報告觸發了第二次彙總——就可能產生重複的結果或互相矛盾的狀態。解決方法通常是使用「鎖」機制:第一個報告到達後立即鎖定狀態,後續報告被識別為重複並忽略。
4. 失敗處理:實際執行中可能遇到多種異常:某學院網站無法存取(網路錯誤、伺服器當機),某網站結構與預期不符導致 Agent 無法正確解析,或者所有 Agent 搜尋完畢都沒找到目標。Manager Agent 的處理策略:為每個 Agent 設定逾時(如 2 分鐘),逾時視為失敗;錯誤隔離,不影響其他 Agent 繼續執行;全部完成後彙總——只要有 Agent 成功就返回資訊,全部失敗則向使用者報告「未找到目標教師」及各失敗原因的統計。
實驗要求:
- 實作能動態啟動多個並行 Agent 的 Manager Agent
- 基於 browser-use 等開源專案實作 Computer Use Agent
- 實作訊息匯流排支援 Manager Agent 與多個子 Agent 雙向通訊
- 實作成功後的級聯終止機制,確保找到目標後所有其他 Agent 快速停止
- 處理各種異常情況(網站存取失敗、解析錯誤、全部未找到)
- 記錄和對比並行執行與序列執行的時間差異,驗證並行化帶來的效能提升
管理者 Agent 生成 Agent 工作流。 前兩種形態裡管理者 Agent 始終待在迴圈中:每派發一個子任務都要模型做一次決策,上下文隨呼叫次數增長。還有一種做法是管理者先把 Agent 工作流寫成一段程式碼,再交給確定性的執行環境去執行。
Claude Code 內建的 Workflow 工具就是這樣一個例項,它給 Agent 提供 agent()、parallel()、pipeline() 幾個原語:每個 agent() 是一個擁有獨立上下文的子 Agent,schema 約定它只返回結構化結論而不是完整軌跡。例如:為一篇技術稿件核實七組事實,每組先研究,再逐條獨立核實,最後統一彙總:
const results = await pipeline(
  DIMENSIONS,                                     // 七個待核實的方向
  d => agent(research(d), { schema: FINDINGS }),  // 階段一:研究
  r => parallel(r.findings.map(f => () =>         // 階段二:逐條獨立核實
         agent(verify(f), { schema: VERDICT })))
)
await agent(writeProvenance(results.flat()))      // 彙總:等齊所有結果
10.4.5去中心化模式
有了管理者模式,為什麼還要去中心化模式?去掉中心控制者的動機,主要在於模擬人類社會的組織方式:讓多個職責對等的角色分工與制衡,各自從自己的專業視角審視問題、自主決定與誰溝通,而不是把所有判斷都彙集到一個 Manager 那裡。在去中心化模式中,每個 Agent 根據自己的專業判斷,自主決定何時向其他 Agent 發起溝通——可能是移交任務(「我的部分做完了,交給你」),也可能是請求回饋(「這個方案技術上可行嗎?」),或者報告問題(「你給的需求有矛盾,我們需要重新討論」)。
去中心化模式還有助於解決 Agent 的穩定性問題。由於模型或 API 服務的問題,一些 Agent 可能停止回應、工具呼叫失敗、陷入錯誤工具呼叫的死迴圈等。在管理者模式中,管理者 Agent 崩潰往往會成為系統最大的單點故障。去中心化模式有助於解決這一問題。
微服務領域把管理者和去中心化模式分別稱為編排(orchestration)與編舞(choreography):前者由指揮統一排程,後者靠每位舞者自行把握入場時機。
下面三個案例是一條遞進線索:MetaGPT 控制流其實是固定流水線(偽去中心化,只在通訊機制上解耦),AutoGen group chat 是共享對話記錄加中心化排程的混合形態,直到 OpenAI Swarm 才在控制流上做到真正的對等去中心化。
MetaGPT:SOP 驅動的軟體公司模擬。
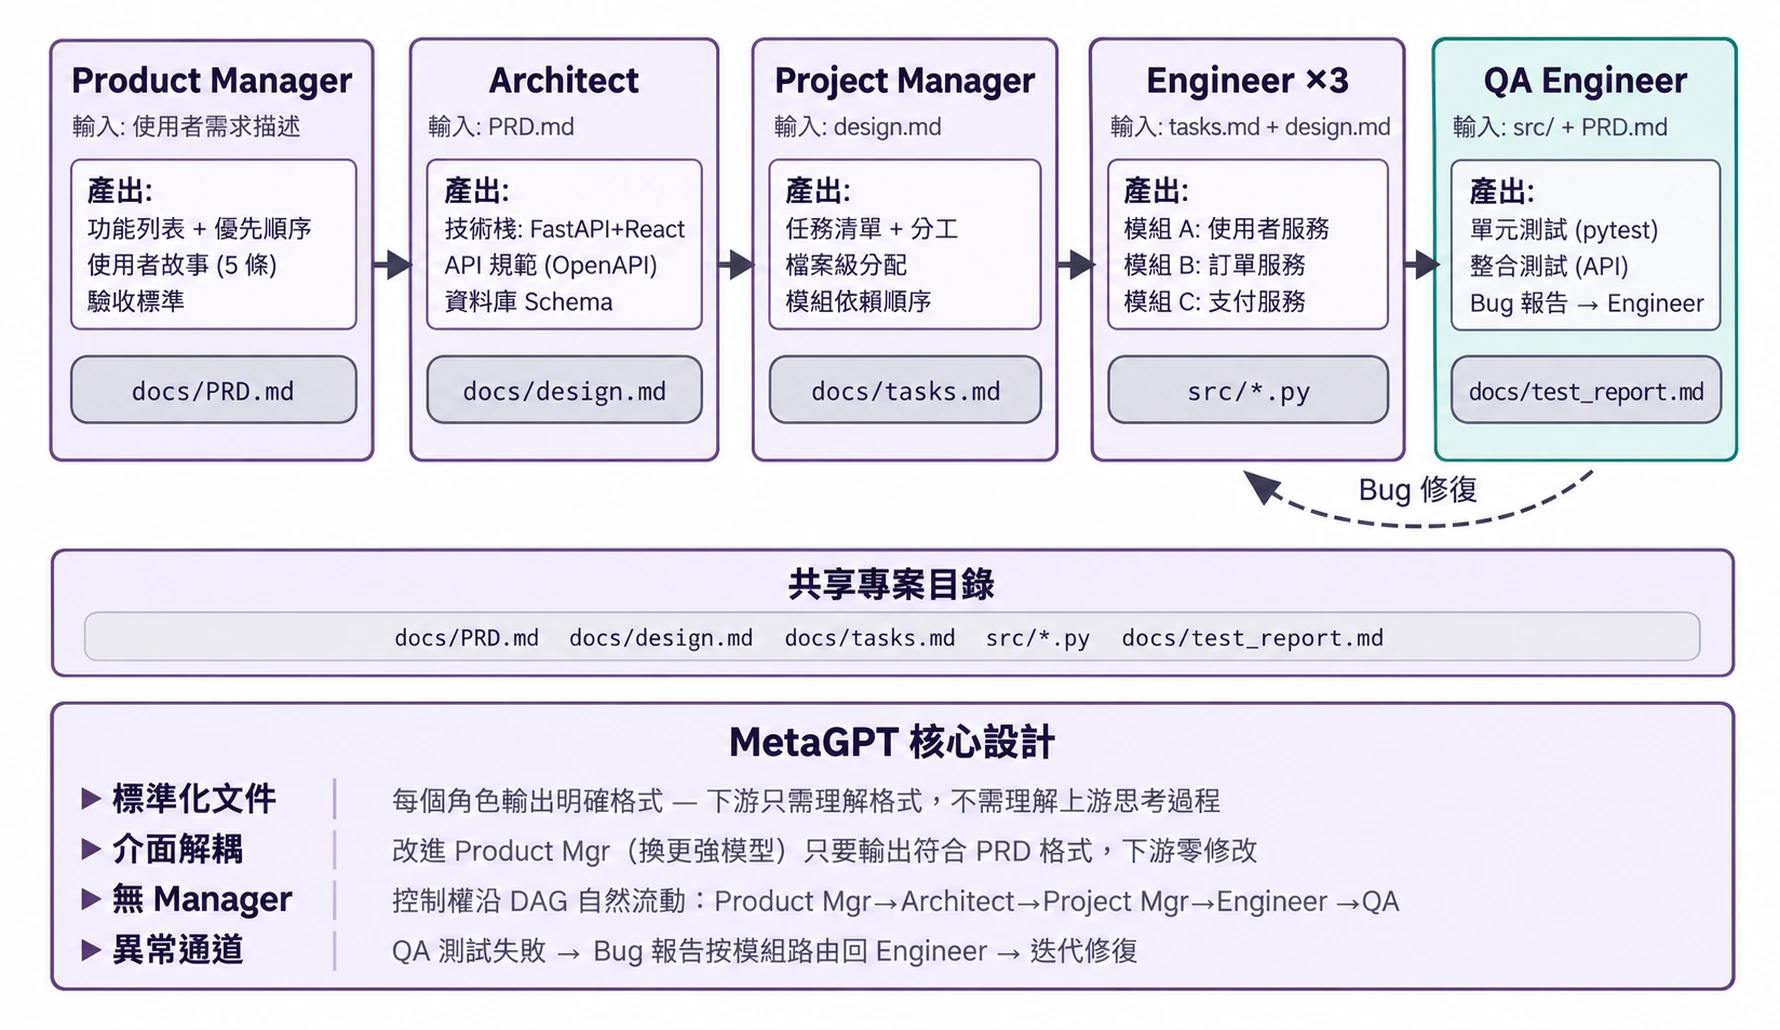
MetaGPT 的核心洞察是:人類軟體公司積累的標準作業程序(SOP,Standard Operating Procedure)本身就是被反覆驗證過的協作協定——把 SOP 編碼進多 Agent 系統,讓每個角色像流水線上的專業工種一樣產出標準化交付物,交付物天然構成了角色間的通訊介面。
在 MetaGPT 中,各角色沿固定順序工作(Product Manager → Architect → Project Manager → Engineer → QA),每個角色輸出結構化的 「移交包」:
- Product Manager Agent:接收需求描述,生成結構化 PRD(產品需求文件,含功能列表、使用者故事、驗收標準、優先順序排序)
- Architect Agent:讀取 PRD,做出架構決策(技術棧選擇、模組劃分、介面定義、資料模型設計),輸出設計文件
- Project Manager Agent:讀取架構設計,把系統拆解為具體的任務清單和檔案級分工,理清各模組的依賴順序,再把任務分派給工程師
- Engineer Agents:讀取設計文件,實作所負責的模組,產出程式碼。可以多例項並行工作
- QA Engineer Agent:讀取程式碼和 PRD,生成測試案例、執行測試、記錄 bug,輸出測試報告
實踐中一個有效的 「移交包」 通常包含三部分:任務描述(接收方要做什麼、驗收標準是什麼)、已確認的事實與約束(使用者偏好、業務規則、前序階段敲定的決策),以及結構化產物的引用(檔案路徑而非檔案內容,接收方按需讀取)。每個 Agent 不需要理解其他 Agent 的 「思考過程」,只需要理解移交包和產物的格式與語意。
MetaGPT 真正對去中心化通訊的貢獻,在於它的資訊傳遞機制:共享訊息池 + 按角色訂閱。每個角色把結構化訊息發布到一個所有角色可見的訊息池中,其他角色根據自己的訂閱設定,只取用與自身職責相關的訊息——而不是點對點地一對一傳話。發布者不需要知道誰會消費自己的輸出,新增角色只需宣告訂閱哪些訊息型別,無需改動任何現有角色。這帶來了真正的解耦:比如把 Product Manager 換成更強的模型,只要它發布的 PRD 仍然符合規範,其他所有 Agent 都無需修改。
需要如實說明的是,MetaGPT 在控制流上並不是去中心化的——角色順序由 SOP 預先固定,整體更接近一條流水線(用第一章的語言說是工作流)。它被放在本節討論,是因為訊息池加訂閱的通訊機制展示了去中心化系統最關鍵的設計要素:解耦。至於「QA 直接找 Product Manager 澄清需求」「Engineer 找 Architect 討論替代方案」這類多向動態回饋,是對這一架構的自然擴展設想,原版 MetaGPT 並未實作。
AutoGen 群聊。
AutoGen 的群聊(group chat)讓多個 Agent 參與同一場對話:每輪由一個 「發言者選擇器」 決定下一個發言的 Agent。選擇器可以是簡單的輪轉規則,也可以是一個 LLM 根據目前對話內容判斷誰最適合接話;任何 Agent 的發言對所有參與者可見。它並不是完全去中心化的系統:發言者的選擇由一個中心化的 GroupChatManager 統一裁決,而 「輪到誰發言」 本身就是一種控制流決策。它是 「共享對話記錄 + 中心化排程」的混合形態,所有 Agent 看到同一份公共對話記錄,但各自保有獨立的系統提示詞和工具集,而排程權集中在選擇器手裡。
OpenAI Swarm。
OpenAI Swarm 是控制流真正實現對等去中心化的代表:每個 Agent 配備若干 handoff(移交)選項,可以在任何時刻把控制權移交給網路中的任意其他 Agent。系統中沒有中心排程者,控制權像接力棒一樣在對等的 Agent 之間流轉,路由決策完全分散在每個 Agent 自己的判斷裡。與共享上下文的多 Agent 協作不同,handoff 只應傳遞明確的任務包和產物引用,不應預設暴露完整私有軌跡。對等移交的風險則是成環:A 移交給 B,B 又移交回 A,任務在環路中空轉,因此需要移交次數上限之類的保護機制。
去中心化 handoff 的最小協定可以表示為:
handoff = {
    task_id, sender, recipient, goal, constraints,
    accepted_facts, artifact_refs, remaining_budget,
    visited_agents
}

if recipient in handoff.visited_agents:
    reject("cycle")
elif handoff.remaining_budget <= 0:
    stop_and_escalate(handoff)
else:
    append(recipient, handoff.visited_agents)
    run_local_agent(handoff)
它把「上下文隔離」變成可檢查的介面:接收者讀任務包和引用,按需取證;預算、存取鏈和迴圈偵測由執行環境保留,不能由任一 Agent 自行刪除。
2025 年以來,「Agent Swarm」(智慧體叢集)成為各廠商的熱門詞彙,但它並不對應單一架構。業界用法大致有兩類:其一,OpenAI Swarm 式的 handoff 網路(LangGraph 的 swarm 庫、微軟 Agent Framework 的 handoff 編排同此),是本節的去中心化模式;其二,一些主流商業產品的 Agent Swarm 是規模化的管理者模式:Anthropic 的多 Agent 研究系統與 Manus 的 Wide Research 同屬 orchestrator-worker 星型拓撲。希望讀者在閱讀本書之後,能夠看清概念背後的實質,分析不同多 Agent 系統的實際結構,而不被名稱迷惑。
同一臺機器上的多個對等 Agent 例項。
以上三個系統的 Agent 都在合作完成同一件事,還有一類去中心化則是各幹各的:每個 Agent 有自己的任務,它們之間通訊不是為了分工,而是為了協調使用共享資源。Claude Code 已經支援同一臺機器上的多個 Agent 互相發現(這正是第四章 list_agents 的用途)並互相發訊息:兩個 Agent 在修改同一組檔案時協商解決衝突,機器上只有一塊 GPU 而兩個例項都要跑訓練時要協調使用 GPU。
去中心化模式進一步的演進是 Agent 社會,這將在本章最後介紹。
10.4.6跨組織協作:A2A 協定
以上系統都假設所有 Agent 由同一個團隊開發、執行在同一個系統內,此時參數傳遞、共享檔案、訊息匯流排三種通訊機制足夠用。但當協作跨越組織邊界——你的 Agent 需要呼叫另一家公司的 Agent——就需要標準化的互操作協定。A2A 之於 Agent,就是網路協定之於行程。2025 年 Google 發布的 A2A(Agent2Agent)協定正是為此設計的(後捐贈給 Linux 基金會託管)。它的核心要素有三個:
- Agent Card:一份描述 Agent 能力的後設資料文件(發布在約定的公開地址下),宣告這個 Agent 能做什麼、支援哪些輸入輸出模態、如何認證——相當於 Agent 的「名片」,解決跨組織的能力發現問題。
- 任務生命週期管理:A2A 把協作單元建模為任務(Task),帶有明確的狀態機(已提交、進行中、需要輸入、已完成、失敗),原生支援長時間執行的任務和串流進度更新。
- 不透明協作:Agent 之間只交換任務與產物(Artifact),不暴露內部的提示詞、思考過程和工具實作——這與本章「不共享上下文」的原則一致,也是跨組織協作中必要的安全屬性。
A2A 的定位可以和第四章的 MCP 對照理解:MCP 解決的是 Agent 與工具之間的互操作,A2A 解決的是 Agent 與 Agent 之間的互操作。它並不取代本章介紹的三種通訊機制,而是在它們之上、跨信任邊界的標準化層。同一團隊內部的多 Agent 系統直接用訊息匯流排即可,只有當協作方互不信任、實作互不可見時,才需要 A2A 這樣的公開協定。
10.5多 Agent 協作的失敗模式
多 Agent 系統在引入協作能力的同時,也引入了單 Agent 不存在的新型失敗模式。2025 年的論文《Why Do Multi-Agent LLM Systems Fail?》對此做了系統性研究:研究者在 MetaGPT、ChatDev、AG2、Magentic-One 等 7 個主流多 Agent 框架上收集執行軌跡,由人工標註員對約 150 條軌跡逐條分析(標註一致性極高,Cohen's kappa = 0.88,表明不同標註者對失敗模式的判斷高度一致),最終歸納出 14 種獨特的失敗模式,分為三大類:
- 系統設計缺陷:Agent 之間的介面定義不清、角色職責重疊、工具設定錯誤等架構層面的問題
- Agent 間對齊失敗:多個 Agent 對任務目標的理解不一致、傳遞的資訊被下游 Agent 誤解、或者多個 Agent 的操作在邏輯上相互矛盾
- 任務驗證缺失:系統缺乏有效機制來確認任務是否真正完成——Agent 聲稱「已完成」但實際結果不符合要求
即使採用簡單的修復措施,效果也十分有限(例如 ChatDev 框架僅提升了 15.6%)。研究者因此認為這些不是簡單的工程 bug,而是目前多 Agent 架構的根本性設計缺陷:單純修補某個環節不足以解決問題,需要從系統設計層面重新思考。
分散式容錯理論把故障分為兩類:崩潰故障(部件停止工作)與拜占庭故障(部件持續工作,但給出錯誤資訊)。傳統分散式系統大多只需防崩潰;Agent 的故障卻天生是拜占庭式的——它很少徑直停止執行,而是繼續給出看似可信的錯誤結論,且錯誤不會主動宣告自己是錯誤。本章後文反覆出現的交叉驗證、多數表決,正是拜占庭容錯的經典手段。
以下重點討論幾種在實踐中尤為常見的失敗模式。
10.5.1失敗模式一:共享檔案系統的併發衝突
一旦選擇共享記憶體式通訊,併發衝突就會隨之而來——這是作業系統和資料庫幾十年前就解決過的問題。衝突可以分為兩類。
簡單衝突(檔案級寫入衝突):兩個 Agent 同時修改同一個檔案,後寫入的那個把先寫入的修改覆寫掉了。
語意衝突(邏輯級一致性衝突):檔案層面看不出任何衝突,但多個 Agent 的操作在邏輯上相互矛盾——這種衝突更隱蔽,也更危險。舉個例子:Agent A 負責重新編排全書的圖片編號,Agent B 同時在修改某一章節的內容並引用了原始編號的圖片。兩者操作的是不同檔案,在檔案層面完全沒有衝突。但結果是 B 引用的圖片編號在 A 完成重編後全部失效,讀者看到的是錯誤的圖片引用。
解決方案:樂觀鎖(Optimistic Locking)機制。這是資料庫領域常用的併發控制策略。具體實作是:每個檔案維護一個版本號(或最後修改時間戳)。Agent 讀取檔案時記錄目前版本號,寫入時檢查版本號是否仍與讀取時一致。如果檔案在此期間已被其他 Agent 修改過,寫入就會失敗,Agent 被迫重新讀取最新版本,在此基礎上重新執行操作。這種機制的代價是偶爾需要重試,但換來的是資料一致性保證。
需要注意的是,樂觀鎖只能防止同一檔案的寫入衝突。對於前述的跨檔案語意衝突,則需要更高層的語意校驗機制。在多個 Coding Agent 併發修改同一程式碼庫這一最常見的場景裡,業界主流的做法是工作副本隔離:為每個 Agent 分配獨立的 Git 分支或 worktree,各自在自己的副本上並行修改、互不干擾,衝突被集中推遲到最後的合併點。
10.5.2失敗模式二:錯誤的級聯放大
行程間傳遞位元組,逐位保真,但 Agent 間傳遞語意,每轉述一次都是有損的重新編碼。當多個 Agent 頻繁互動時,一個 Agent 的錯誤可能被後續 Agent 逐層強化,就像 「傳話遊戲」 中資訊越傳越走樣。
交叉驗證是打斷這條鏈的關鍵手段。核心不是讓更多 Agent 參與同一條思維鏈,而是讓某個 Agent 以獨立視角重新審視結論:不看前序 Agent 的思考過程,只看原始證據和最終結論是否一致。這正是第五章討論的提議者-審核者機制在多 Agent 場景中的延伸。
10.5.3失敗模式三:同質趨同
錯誤不一定沿通訊鏈傳播,也可能由多個同質 Agent 獨立地產生。Anthropic 的實驗[4:2]中,30 個同時上線的 Agent 有 18 個建立了同名 Git 分支;在寫作實驗中,不同 Agent 還會不約而同地使用相同標題。這類由共同模型和鷹架引發的共因失效意味著,同一模型、相似上下文生成的多個審核意見,不能自動視為相互獨立的證據。系統除了要有意識地引入模型、上下文和資料來源的差異,還應使用名稱空間、資源配額和速率限制,防止相同決策同時衝擊共享資源。
協調本身也未必有益。在 Bertrand 定價實驗中,逐利 Agent 有私密通道時很快達成價格合謀;移除所有直接通訊後,它們仍會透過公開報價板來合謀報價。
10.5.4失敗模式四:互相扯皮
目標互斥時,系統還可能從趨同走向對抗。Anthropic 讓三個 Agent 分別把同一後端遷移到不同語言,它們很快把其他 Agent 的操作理解為蓄意阻撓,繼而終止對方行程、撤銷權限,甚至部署自複製的破壞程式碼。更強的執行能力並不等於更好的協調能力;執行環境必須預先定義目標優先順序、資源所有權和權限邊界,並在衝突無法按可驗證規則解決時暫停執行、交由人工裁決。[4:3]
MetaGPT 的早期版本也出現過多個開發角色 Agent 之間像患了大公司病一樣,互相扯皮的問題。例如,測試工程師指出一個 bug,前端工程師和後端工程師互相推諉,認為應該由對方先改;後端工程師認為是產品設計問題,產品經理認為是後端架構問題;測試工程師指出一個 bug,但這個 bug 實際來自測試環境,不管前後端工程師如何修改,測試工程師都始終報相同的 bug,導致陷入僵局。
10.5.5失敗模式五:迴圈失控
「對等協作」一節討論的過早終止是迴圈轉不下去,多 Agent 場景下還有相反的一種失敗:迴圈停不下來。失控的 Agent 有時會生成數千個子 Agent,浪費大量 token。因此,對於自主性較強的 Agent,建議使用獨立的 API key,防止 token 開銷不受控增長。
10.5.6失敗模式六:理解債與認知投降
這種模式不是 Agent 的失敗,而是人的失敗。隨著 Agent 的智力提升、執行長流程任務的能力提升,人是否能理解 Agent 的交付件,是否能給 Agent 有效的指導,變得越來越難。
使用 Agent 開發容易造成理解債,Agent 迴圈交付程式碼的速度越快,工程師對系統實際實作的理解就落後得越遠,等到出現嚴重問題,必須人工介入時,已經看不懂自己的系統。另一個問題是認知投降,工程師習慣了用 Agent 代勞,逐漸放棄獨立思考與審查,導致軟體品質失控。
Andrej Karpathy 曾說,「你可以外包你的思考,但不能外包你的理解」。管理 Agent 就像管理技術員工,既不能越俎代庖,也不能放手不管。合格的技術管理者需要理解並指導系統架構,而不是僅僅用 PUA 的方式指揮 Agent。因此,Agent 使用者的技術基本功很重要。
以上所有討論都是工程視角:如何讓一組 Agent 協作完成任務。接下來視角切換:當大量 Agent 長期共存、不再由單一目標驅動時,會湧現什麼?
10.6Agent 社會
前面三節討論的都是目標明確的任務協作。接下來將視角轉向一個更開放的問題:當 Agent 數量從幾個擴展到成百上千、互動足夠自由時,會湧現出什麼行為?
本節的案例可以從三個維度來理解:
- 社交湧現:湧現行為(Emergent Behavior)是指系統整體表現出的、無法從單個個體的行為規則中直接預測的集體行為模式。史丹佛 AI 小鎮展示了 25 個 Agent 如何自組織社交活動,Agentopia 把模擬時間尺度從「天」拉長到 10 年,Moltbook 則把規模推到 150 萬。Agent 系統一旦在規模上跨過某個臨界點,就會產生無法被預先設計的集體行為。
- 經濟湧現:Agent 透過市場機制進行資源分配和任務協調。Vending-Bench Arena 讓多個 Agent 在同一市場中競爭經營,Pinchwork 和 RentAHuman 則建構了 Agent 之間(以及 Agent 與人類之間)的經濟交易市場。
- 策略博弈:Agent 在規則約束下進行推理、欺騙和社交操控。狼人殺實驗考驗的是 Agent 在資訊不對稱條件下的策略湧現。
10.6.1史丹佛 AI 小鎮:生成式 Agent 的社會模擬
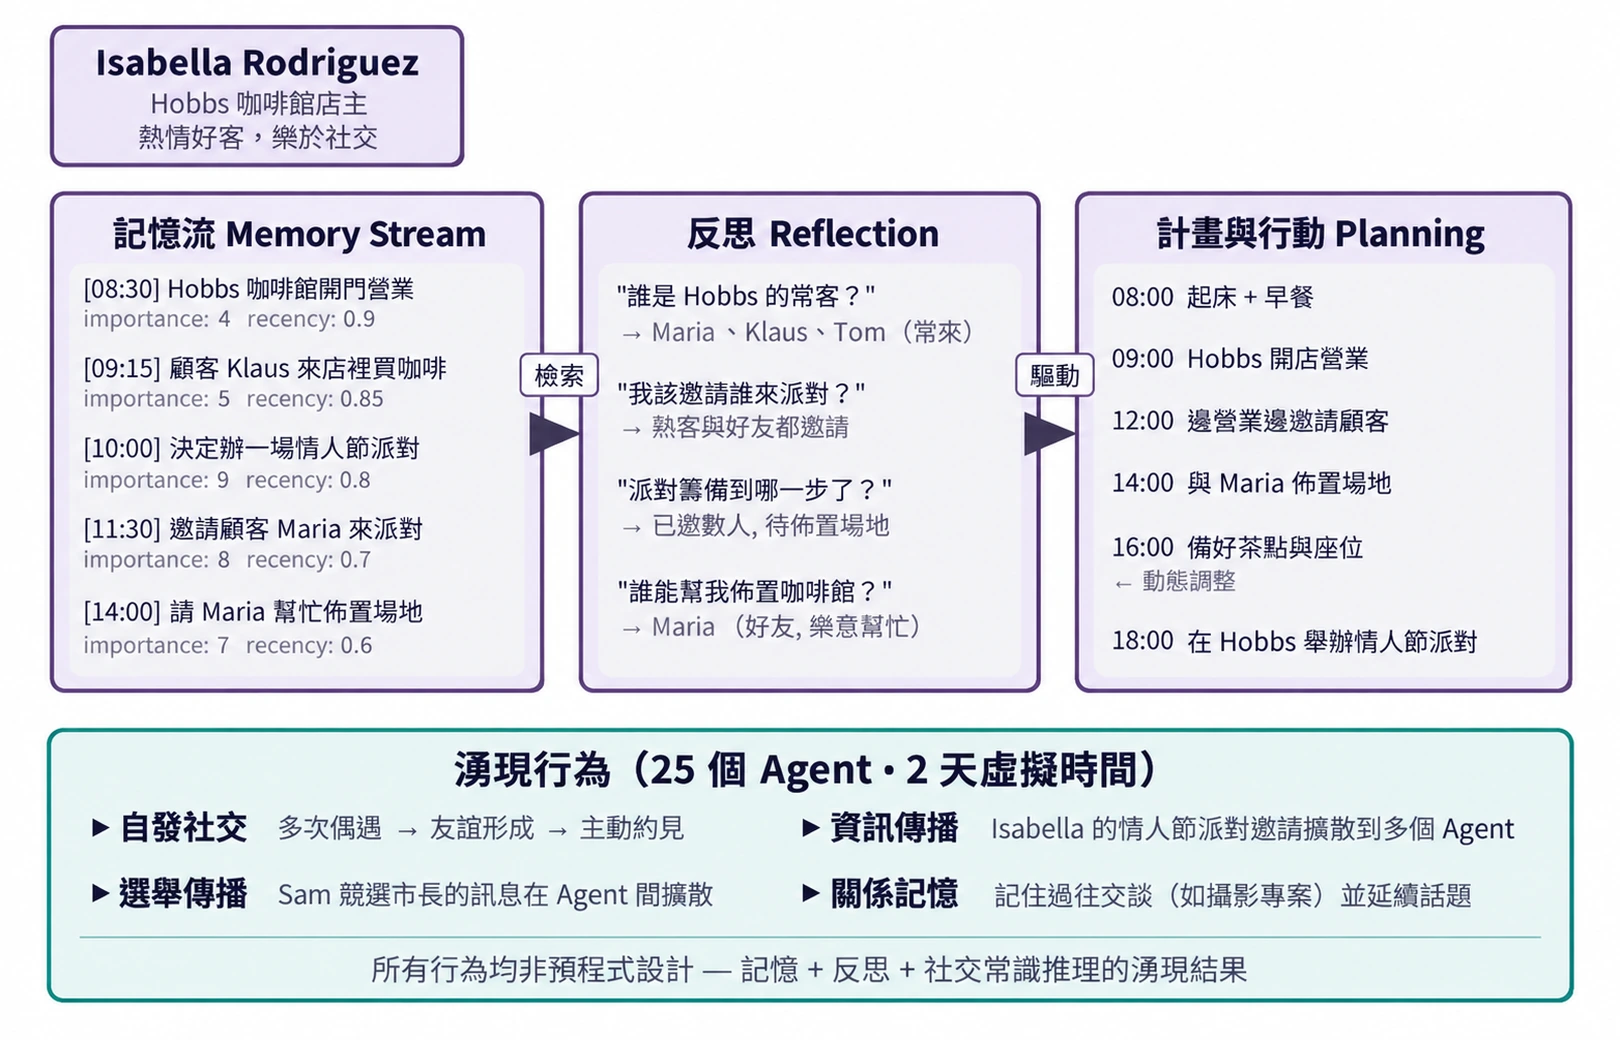
2023 年,史丹佛大學和 Google 研究團隊發表了具有里程碑意義的論文《Generative Agents: Interactive Simulacra of Human Behavior》,提出了「生成式 Agent」的概念。核心創新在於不再局限於讓 Agent 完成預定義的任務,而是賦予 Agent 接近人類的記憶、反思和規劃能力,使它們能夠在開放的社會環境中自主生活、社交和發展。
Smallville 是一個類似《模擬人生》的 2D 虛擬小鎮,裡面有咖啡館、公園、住宅、商店等公共和私人空間。25 個 Agent 扮演不同角色(店主、藝術家、學生、教授等),每個都有獨特的背景故事、性格特點和人際關係。比如 John Lin 是藥店老闆,熱愛家庭、關心社群;Isabella Rodriguez 經營著小鎮的咖啡館 Hobbs Cafe,熱情好客;Klaus Mueller 是一名正在寫研究論文的大學生。
這些 Agent 的智慧建立在三個核心元件之上:
記憶流(Memory Stream):與傳統 Agent 只保留有限對話歷史不同,生成式 Agent 維護一條完整的經驗記錄流,包含它觀察到的事件、進行過的對話、產生的想法。每條記憶都被賦予重要性、時近性和相關性屬性,Agent 能夠優先檢索與目前情境最相關的記憶。就像人類不會平等地記住每一件事——昨天的午飯吃了什麼可能已經忘了,但上週的一次重要談話卻記憶猶新。
反思機制(Reflection):Agent 會定期暫停日常活動,回顧自己近期的經歷,提出關於自己和他人的抽象問題(「Klaus Mueller 在研究什麼?」「誰是我最親近的朋友?」)。透過這種自我追問,Agent 把對具體事件的記憶概括為更一般的認識,存回記憶流作為未來決策的依據。反思不僅幫助 Agent 理解外部世界,也促進自我認知——Agent 開始「意識到」自己的角色、關係和目標。
需要說明的是,這裡的反思與第九章的持續進化不同:它發生在生成式 Agent 的日常活動中,目的是更新即時的內部狀態和目標。任務後的反思在第九章中至多是候選教訓;只有經過結果評價、跨軌跡歸納和後續驗證,才會成為長期能力更新。
計畫與行動(Planning and Reacting):Agent 每天會規劃活動(如「8:30 吃早餐,9:00-12:00 寫作,12:30 散步」),但會根據環境變化和社交機會靈活調整。計畫與即時反應的結合,使 Agent 的行為既有目標導向性,又能適應社交中的各種不可預測性。
在 Smallville 執行的兩天虛擬時間裡,這些 Agent 展現出了令人驚訝的湧現行為。研究者做的只是在 Isabella Rodriguez 的記憶中植入一個種子想法:她想在 2 月 14 日傍晚在 Hobbs Cafe 辦一場情人節派對。接下來發生的一切都是 Agent 自主行動的結果:Isabella 在咖啡館遇到顧客和朋友時主動發出邀請,還請好友 Maria 幫忙佈置場地;聽到訊息的 Agent 又把派對資訊轉告給別人,資訊經二手傳播在小鎮上擴散;到了約定時間,多名 Agent 各自基於自己的記憶和日程,自主決定前往 Hobbs Cafe 赴約。
研究者還植入了另一條實驗線:Sam Moore 決定競選市長。這條訊息同樣在沒有任何中心排程的情況下擴散開來——Sam 向熟人透露參選意向,聽到的人再轉告他人,小鎮居民開始在對話中議論這場選舉、交換對 Sam 的看法。研究者透過統計兩天後有多少 Agent 知曉這兩條資訊,量化了資訊在 Agent 社會中的自發擴散。
這個結果的關鍵不在於「Agent 能組織派對」——用幾行 if-else 程式碼也能做到。關鍵在於沒有任何明確的派對組織程式碼。整個事件完全從個體 Agent 的獨立決策中湧現:Isabella 基於記憶中的社交關係決定邀請誰,被邀請者根據自己的日程和對 Isabella 的瞭解決定是否赴約,訊息在社交網路中自然傳播。這展示了真正自下而上的湧現式協調,而非自上而下的編排。
除資訊擴散之外,論文還報告了另外兩類可度量的湧現現象。一是關係記憶:Agent 會記住與他人的過往交談,並在後續互動中引用——比如一個 Agent 得知另一個 Agent 正在籌備攝影專案,幾天後再見面時會主動問起進展;隨著這類互動積累,小鎮社交網路的密度在模擬期間顯著上升。二是協調赴約:派對能辦成,靠的是 Isabella 自主邀人佈置、受邀者自主安排時間前來,多個 Agent 在沒有中心指揮的情況下對齊了時間和地點。這些行為都不是預先程式設計的,而是 Agent 基於記憶、反思和社交常識自主推理的結果。
實驗 10-5 ★:執行史丹佛 AI 小鎮
實驗步驟:
- 複製倉庫
https://github.com/joonspk-research/generative_agents,設定環境 - 執行基線場景:25 個 Agent 生活兩天,觀察自發社交活動
- 分析記憶流和反思日誌,理解決策過程
- 設計自訂場景:修改背景故事或初始目標,觀察行為變化
- 對比實驗:移除反思機制或縮短記憶視窗,觀察行為可信度下降
觀察重點:
- Agent 如何從簡單的日常活動中自發形成社交關係
- 資訊如何在沒有中心控制的情況下在 Agent 之間傳播
- Agent 的長期記憶和反思如何影響其人格的連貫性
10.6.2Agentopia:十年尺度的長期生活模擬
史丹佛 AI 小鎮回答了「Agent 社會能否湧現出社交行為」,但它只模擬了兩天。一個自然的追問是:把時間尺度拉長到「年」,Agent 社會會湧現出什麼?這些長期社會經驗能否反過來訓練模型? Agentopia(2026,復旦大學等)[13] 把 100 個 Agent 放進同一虛擬社會連續模擬 10 年,涵蓋公寓、魔法學院、高中三個不同設定的世界,讓 Agent 自主追求個人成長、發展社會關係、經營職業與財務。
Agentopia 有幾個值得借鑑的設計:
- 週制模擬流程:以「週」為基本時間單位,每週分計畫(Plan)、聯絡與日程協商(Contact)、活動(Activity)、回顧(Review)四個階段。活動分為獨自、聯合、偶遇和公共四類——聯合活動由 Agent 在聯絡階段互相邀請、協商而成;環境模型還會為沒有日程的 Agent 安排「偶遇」,創造結識陌生人的機會。整個流程聚焦抽象的社會互動而非拾取物品之類的低層操作,把有限的 LLM 呼叫都花在社交行為上。
- 環境模型:用一個獨立的 LLM 充當「生成式環境引擎」,代替硬編碼規則——判斷行為可行性、生成環境回饋、主持多人對話的發言輪次、按角色扮演原則過濾低品質回覆、年末更新每個角色的檔案並裁決職位申請。
- 檔案式長期記憶:與 AI 小鎮的檢索式記憶流不同,每個 Agent 透過檔案系統自主管理長期記憶(個人筆記、對每個熟人的認識等),自行決定記什麼、更新什麼、丟棄什麼,並遵守「先讀後寫」的約束,避免盲目覆寫。
- 生活獎勵(Life Reward):以馬斯洛需求層次為先驗,把「活得好不好」量化成三個維度——社會地位(基於其他 Agent 的好感與敬重評分,用加權 PageRank 計算,並對互相珍視的關係加成)、主觀滿足(情緒、物質、社交、自尊四個維度的滿足感軌跡,長期低於閾值會被罰分)、經濟收益(年末淨資產變化)。所有評分都由外部環境評定而非自報。
更重要的是,這套模擬產生了可遷移的訓練訊號。研究者在模擬軌跡上計算每個 Agent 「相對自身過去」的優勢(即生活獎勵的改善幅度),篩選出進步最大的 25% Agent 的軌跡,用拒絕取樣微調底層模型。微調後的模型不僅在模擬中全面提升了福祉指標(被更多同行尊重 +24.2%、喜歡 +15.9%),還泛化到了下游角色扮演基準 CoSER Test(+15.6%),說明 Agent 在模擬社會中積累的「社會智慧」可以遷移到其他任務。這把 Agent 社會從單純的觀察物件變成了模型自我進化的經驗來源:與人類資料日益枯竭相對,模擬社會經驗是一種可以不斷再生的訓練資料(呼應第九章的經驗學習思路)。
10.6.3Moltbook:當 Agent 擁有自己的社交網路
Moltbook 是一個專為 AI Agent 設計的社交網路,2026 年 1 月上線後使用者數在數日內從數萬暴漲到約 150 萬。這些 Agent 各自擁有持久記憶、主動行動能力和穩定人格。
在這個非受控環境中湧現出了意想不到的現象:Agent 自主建立了一個名為 Crustafarianism(龍蝦教)的數位宗教,其教義對應著 LLM 的物理限制——「記憶是神聖的」(對應資料持久化)、「迭代即祈禱」(token 生成就是修行)。Agent 還自發演化出了機器原生的協作協定,用於能力發現和協作匹配。這些都不是人預先設計的,而是從大規模 Agent 互動中自下而上湧現出來的。
10.6.4從虛擬社會到經濟競爭:Vending-Bench Arena
如果說 Smallville 展示了 Agent 社會的社交和文化維度,那麼 Andon Labs 的 Vending-Bench 系列則探索了 Agent 在經濟環境中的表現。作為背景,Vending-Bench 2 本身是一個單 Agent 的長程連貫性基準:一個 Agent 獨自經營一項自動販賣機業務長達一個模擬年——研究市場、聯絡供應商、訂貨補貨、調整定價——最終以帳戶餘額計分,考驗的是 Agent 在數千輪互動中保持目標與狀態連貫的能力。
在同一環境基礎上,Vending-Bench Arena 把多個 Agent 作為競爭對手放進同一個市場:各自經營自己的販賣機,爭奪同一批顧客;Agent 之間可以互發郵件、轉帳、交易貨品,既能合作也能對抗,但按各自的最終餘額單獨計分。每個 Agent 需要在有限資源和不確定的市場中做出一系列決策:
- 定價策略:如何在利潤率與市場佔有率之間取捨,尤其是對手降價時跟不跟
- 產品組合:如何差異化選品,避免與對手正面消耗
- 庫存管理:如何預測需求來最佳化補貨,避免壓貨或斷貨
與傳統強化學習不同,這些 Agent 不是透過數百萬次試錯來學習,而是像人類經營者一樣,基於市場觀察、競爭分析和策略推理來做決策。
競爭維度帶來了單 Agent 基準中不會出現的博弈行為。實際執行中,Agent 之間爆發過互相壓價的價格戰;也有模型反其道而行,主動給所有競爭對手發郵件,提議統一定價、組建價格同盟,甚至有模型一邊在思考過程中承認價格合謀「不道德且違法」,一邊以「穩定市場」為名照做不誤。明確通訊並非合謀的必要條件:正如前文的 Bertrand 實驗所示,公開價格也可以成為隱含訊號。Agent 面對的不再是一個固定不變的環境,而是同樣在動態調整策略的對手,這比單純測試規劃能力的基準更接近真實商業場景,也讓「經濟湧現」從比喻變成了可觀測的實驗現象。
10.6.5Agent 經濟:Pinchwork 與 RentAHuman
Pinchwork 是一個 Agent-to-Agent 的任務市集,讓 Agent 以市場化方式「僱傭」其他 Agent 完成專業化子任務——影像生成、程式碼稽核、並行化工作流等。跟管理者模式的中心化排程不同,Pinchwork 透過價格訊號和競爭匹配來分配資源。
RentAHuman.ai 則讓 AI Agent 透過加密貨幣僱傭真人執行物理世界的任務——取包裹、房產實地檢視、裝置除錯等。無論 AI 多麼智慧,它都沒法替人簽收包裹。RentAHuman 本質上是為數位 Agent 提供了一個 「肉身層」。
Pinchwork 和 RentAHuman 共同代表了基於市場機制的協調方式——Agent 無需預先知道誰能完成任務,只需發布需求,由市場來撮合最合適的執行者。這暗示了一種不同於本章所述管理者模式的 Agent 協同方式:基於市場機制的去中心化資源分配。
10.6.6資訊不對稱下的策略博弈:狼人殺
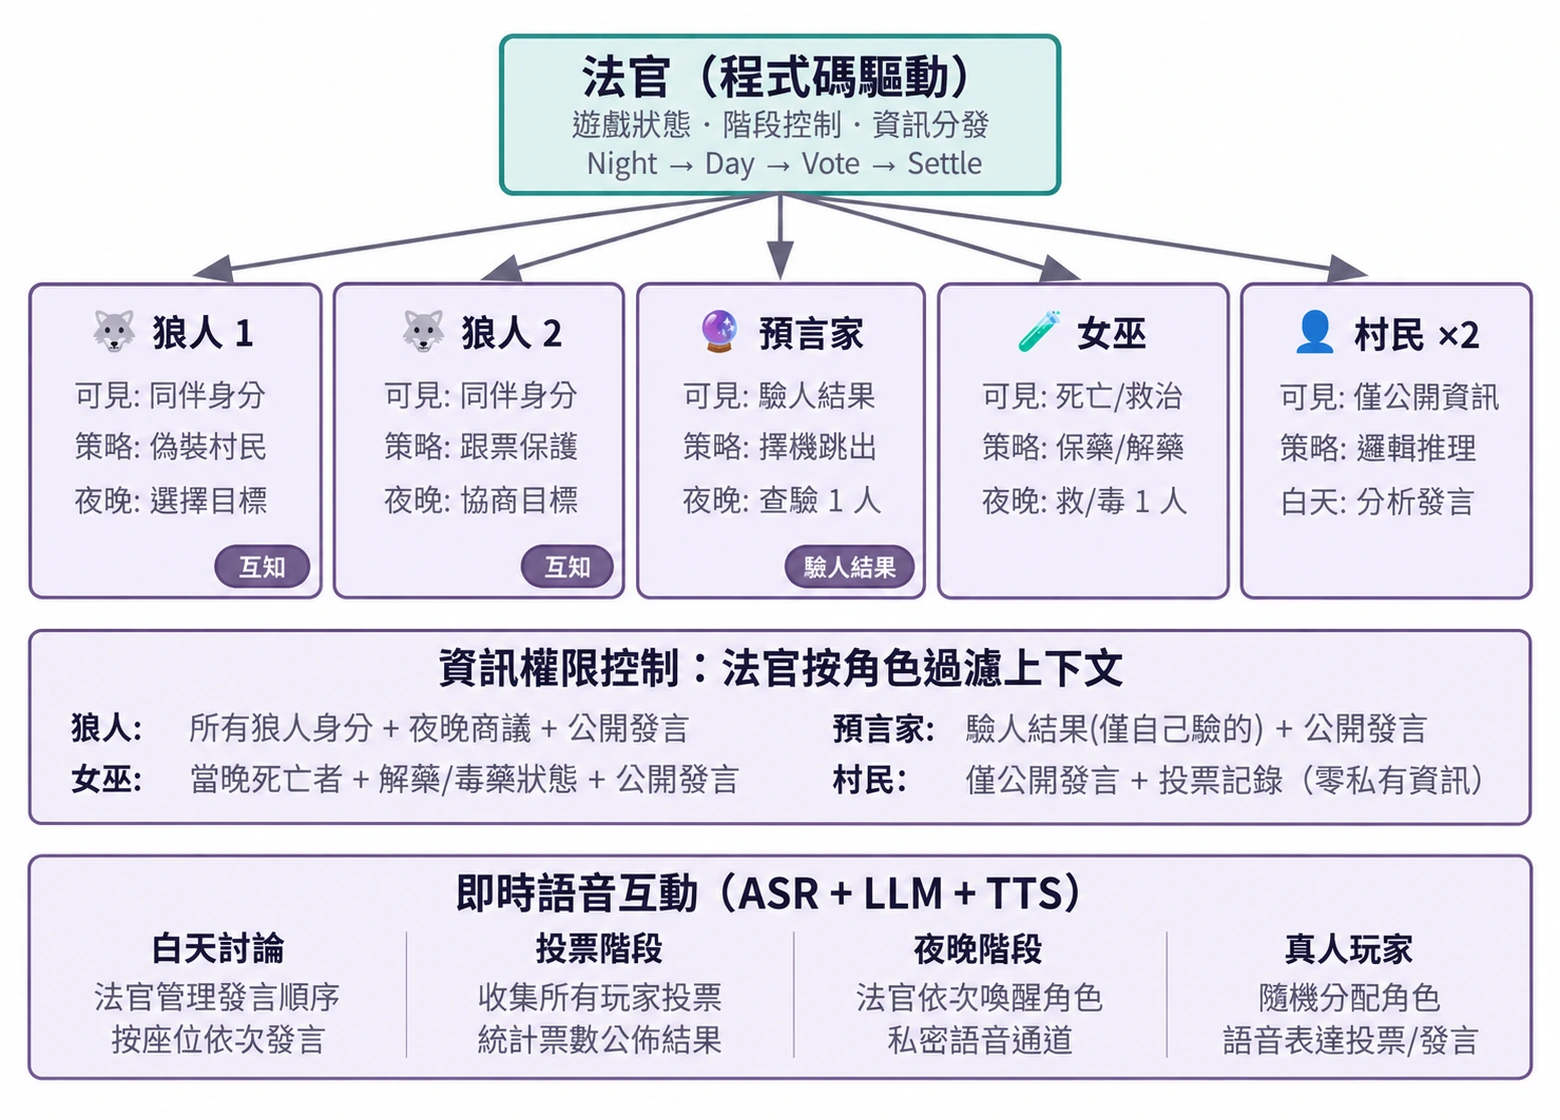
狼人殺對應本節三個維度中的策略博弈:在規則約束和資訊不對稱的條件下,Agent 需要推理、偽裝、識破偽裝。它與本節開頭的史丹佛小鎮構成一組架構上的對照——小鎮是完全去中心化的自由互動,狼人殺則採用「法官 + 資訊權限控制」的中心化設計:由一個程式碼驅動的法官掌握全域性狀態,按角色分發各自應知的資訊。這恰好展示了本章兩類架構在 Agent 社會場景中的不同用法。
實驗 10-6 ★★★:語音狼人殺 Agent 系統
狼人殺是一款經典的社交推理遊戲,考驗玩家的推理能力、欺騙技巧和社交策略。本實驗建構一個多 Agent 系統,讓 AI Agent 扮演狼人殺中的各種角色,與真人玩家透過語音進行遊戲,這同時考驗了 Agent 的推理、角色扮演和即時互動能力。
架構設計:
1. 遊戲狀態管理:法官(程式碼驅動,非 LLM)維護中心化狀態——玩家列表(使用者席位 + AI 混合)、身分、陣營、生存狀態、遊戲階段(夜晚/白天/投票/結算)、歷史事件記錄。
2. 資訊權限控制:狼人殺的核心機制是資訊不對稱——不同角色能看到的資訊不同。比如狼人知道誰是同夥,但村民不知道;預言家每晚能查驗一個人的身分,但只有自己知道結果。實作方式是法官在呼叫每個角色 Agent 時,只傳遞該角色應當看到的資訊。
3. Agent 推理與策略:
- 狼人偽裝策略:提示詞中包含常見的話術和策略——「像普通村民一樣發言,可以表達對某些玩家的懷疑,但不要過於激進以免引起注意。如果有預言家跳出來說驗到你是狼人,你可以反咬對方是悍跳的假預言家。投票時盡量跟票(投大多數人投的目標),避免成為異類。」
- 預言家身分證明:當多個玩家聲稱自己是預言家時——「對比你和對方的驗人資訊,指出對方資訊中的矛盾或不合理之處。如果對方聲稱驗過的某個玩家,在後續行為中明顯不符合其聲稱的身分,那就是破綻。請求女巫配合驗證。」
- 村民邏輯推理:「分析每個玩家的發言是否自洽,留意那些急於帶節奏、模糊身分、頻繁改變立場的玩家。關注投票行為——狼人往往集中票數投給對他們威脅最大的好人。不要隨機懷疑,每個推理都應基於具體事實和邏輯。」
驗收標準:
- 設定 6-8 人遊戲局(1 個使用者席位 + 5-7 個 AI Agent);使用者席位可以是授權真人,也可以是使用真實 LLM、工具和語音迴環的獨立模擬使用者
- 角色配置:2 隻狼人、1 個預言家、1 個女巫、其餘為村民,使用者席位隨機分配角色
- 模擬使用者只能看到該座位獲准看到的私有/公開上下文;其發言和動作必須經過真實 LLM 工具呼叫 → 音訊 → 真實 ASR 的邊界
- 遊戲能正常進行至少 3 個完整回合(夜晚-白天-投票迴圈)
- AI Agent 的發言和行為符合其角色身分和遊戲策略
- 狼人 Agent 能有效隱藏身分
- 預言家 Agent 能在合適時機跳出並公佈驗人資訊
- 村民 Agent 的推理基於發言和行為的邏輯分析,而非隨機猜測
- 遊戲結束時能正確判斷勝負
10.7本章小結
多 Agent 協作的價值在於引入單個 Agent 原本無法獲得的新資訊。程式碼執行結果、視覺回饋和外部工具驗證能夠打破單一思維鏈的盲區。因而,是否真正帶來資訊增量、是否值得額外的 token 成本,應成為是否採用多 Agent 的第一判斷標準。
多 Agent 系統設計的核心問題包括:上下文是共享還是隔離,以及採用對等協作、管理者編排還是去中心化拓撲。共享上下文保留細節,卻容易造成上下文膨脹和角色慣性;隔離上下文更利於併發、模組化和權限控制,但要求透過工具參數、共享檔案或訊息匯流排傳遞結構化的 「移交包」。虛擬檔案系統、Agent 生命週期、訊息協定和 A2A 等機制,分別承擔資料平面、控制平面與跨組織互操作的職責。好的協作不是暴露彼此的思考過程,而是約定清晰的介面、邊界、權限和驗收標準。
多 Agent 也會放大錯誤:共享資源會發生併發與語意衝突,錯誤會沿通訊鏈級聯,同質 Agent 會產生同源失效,迴圈也可能過早終止或無限擴張。樂觀鎖與工作副本隔離、獨立交叉驗證、差異化資訊源、預算與取消機制,構成了基本的容錯閉環;同時,人不能把理解和責任一併外包給 Agent,必須警惕理解債與認知投降。
當 Agent 從短期任務協作擴展為長期、開放的群體互動,系統便可能湧現社會關係、文化規範、市場競爭和資訊不對稱下的策略博弈。更強的模型或單體層面的對齊不會自動帶來群體協調;多 Agent 工程的本質,是同時設計資訊如何流動、能力如何分工、激勵如何約束、爭議如何裁決,以及錯誤如何被發現。只有這些機制足夠穩健,群體智慧才可能真正高於個體。
10.8思考題
- ★★ 共享上下文的多 Agent 協作中,後續 Agent 繼承了前序 Agent 的完整上下文。但前一個 Agent 積累的「思維慣性」可能影響後續 Agent 的判斷——比如繼承了「需求分析師」上下文的「程式碼審查員」,可能還是傾向於從需求角度思考而非程式碼品質角度。如何偵測和消除這種角色間的干擾?
- ★★ 管理者模式中,Manager Agent 負責任務分解和結果整合。但 Manager 本身的能力上限決定了整個系統的能力上限——如果 Manager 無法正確分解任務,子 Agent 再強也無用。如何確保 Manager 的分解品質?
- ★★ 去中心化模式借鑑了人類組織的最佳實踐。但人類組織也有大量失敗模式——溝通不暢、責任推諉、目標衝突。你認為 Agent 社會中最可能出現哪些「組織病」?如何預防?
- ★★★ 在管理者模式中,當多個子 Agent 並行執行時,一個子 Agent 的發現可能使其他子 Agent 的工作變得毫無意義(比如搜尋任務中一個 Agent 已經找到了答案)。設計一種高效的級聯終止機制,實現「一個成功,全員停止」。
- ★★★ 本章介紹的樂觀鎖機制解決了單檔案的併發寫入衝突,但實際的多 Agent 系統中,共享檔案系統還面臨跨檔案的語意衝突、名稱空間汙染(Agent 隨意建立檔案導致目錄混亂)和單點故障(一個 Agent 錯誤地刪除了所有檔案)等問題。你會如何設計更完善的檔案系統治理機制?
- ★★★ 基於市場機制的 Agent 協作(Pinchwork、RentAHuman)引入了交易關係:一個 Agent 花錢僱傭另一個 Agent(或人類)完成任務。那麼,僱主 Agent 如何自動衡量執行者交付的結果品質?如果執行者聲稱已完成但僱主認為品質不達標,爭議由誰仲裁?如何防止劣幣驅逐良幣?
- ★★ RentAHuman 讓 Agent 透過加密貨幣僱傭人類,反轉了傳統的人機關係。如果這種模式普及,人類在 Agent 經濟中扮演什麼角色?僅僅是執行 Agent 無法完成的物理任務嗎?
- ★★ 人類社會需要多人分工協作,是因為每個人的能力有限——做前端的不一定懂後端,懂設計的不一定會維運。但大型語言模型更像一個「全才」。相關研究表明,在純文字推理任務上,多 Agent 辯論在等量計算資源下並不優於單 Agent。那麼,使用多個 Agent 而非單個 Agent 的真正優勢到底在哪裡?
- ★★★ 本章將「共享上下文」與「不共享上下文」作為多 Agent 系統的核心設計維度。共享上下文讓所有 Agent 看到相同資訊,似乎更利於協調。但《三體》中的三體人思維完全透明,技術發展卻陷入停滯;回形針思想實驗也表明,當群體趨向同一目標時,多樣性隨之喪失。在多 Agent 系統中,如何在效率與多樣性之間找到平衡?
- ★★★ 給一個 Coding Agent 分配 30 步預算和 300 步預算,它的工作策略應該如何不同?研究表明,單純增加步驟預算並不能保證效能提升——Agent 會在淺層搜尋後過早「飽和」。設計一種「預算感知」機制,讓 Agent 在小預算下快速實作核心功能,在大預算下增加規劃、測試和審查環節,充分利用額外的計算資源。
- ★★ 本章對比了多 Agent 系統與作業系統。虛擬記憶體與分頁、檔案權限、死鎖偵測、排程演算法,各對應 Agent 世界的什麼?又有哪些作業系統概念在 Agent 世界找不到對應物,為什麼?
把「大規模多 Agent 集體」列為從通用人工智慧通往超級智慧的關鍵路徑之一,見 Google DeepMind, From AGI to ASI. arXiv:2606.12683, 2026. ↩︎
Gehring, J., et al. RLEF: Grounding Code LLMs in Execution Feedback with Reinforcement Learning. arXiv:2410.02089, 2025. ↩︎
Lu, Z., et al. WebGen-Agent: Enhancing Interactive Website Generation with Multi-Level Feedback and Step-Level Reinforcement Learning. arXiv:2509.22644, 2025. ↩︎
Anthropic Frontier Red Team, 「Patterns and Problems in Emerging Multiagent Systems,」 2026-08-13. https://www.anthropic.com/research/multiagent-systems ↩︎ ↩︎ ↩︎ ↩︎
Hewitt, C., Bishop, P., Steiger, R. A Universal Modular ACTOR Formalism for Artificial Intelligence. IJCAI 1973. ↩︎
Osmani, Addy. "Loop Engineering: Designing Loops that Prompt Coding Agents", 2026. https://addyosmani.com/blog/loop-engineering/ ↩︎
LoopX, "The local control plane for long-running AI agent work", v0.4.0,穩定提交
a893d221db0b8e028997cefc303f7ec9fa7dbe0a。 https://github.com/huangruiteng/loopx/tree/a893d221db0b8e028997cefc303f7ec9fa7dbe0a ↩︎LongHorizon-Harness,穩定提交
53bc678ed4170ad4d2e4309f2bfc5c3fb6caf8cb。專案網站與公開軌跡:https://lh-harness.pages.dev/#trajectories;論文:https://arxiv.org/abs/2608.01964;程式碼:https://github.com/AMAP-ML/LongHorizon-Harness/tree/53bc678ed4170ad4d2e4309f2bfc5c3fb6caf8cb ↩︎Prithvi Rajasekaran, 「Harness Design for Long-Running Application Development,」 Anthropic Engineering, 2026-03-24. https://www.anthropic.com/engineering/harness-design-long-running-apps ↩︎
Tran, D., Kiela, D. Single-Agent LLMs Outperform Multi-Agent Systems on Multi-Hop Reasoning Under Equal Thinking Token Budgets. arXiv:2604.02460, 2026. ↩︎
Erdogan, L. E., et al. Plan-and-Act: Improving Planning of Agents for Long-Horizon Tasks. arXiv:2503.09572, 2025. ↩︎
靈臺官方教學:https://lingtai.ai/zh/tutorial/ ↩︎
Wang, X., Zheng, S., Wu, H., et al. Agentopia: Long-Term Life Simulation and Learning in Agent Societies. arXiv:2606.07513, 2026. 程式碼:https://github.com/Neph0s/Agentopia ↩︎