AI 知識
感知、判斷、行動
你已經很熟悉會寫字、畫圖、回答問題的生成式 AI。Physical AI(實體 AI)往前跨了一步:它不只輸出文字,而是要讀懂周遭環境、做出判斷,最後讓機器在真實世界採取動作。
最簡單的理解方式,是把它拆成三個連續步驟:感知、判斷、行動。
第一步:感知周遭發生什麼事
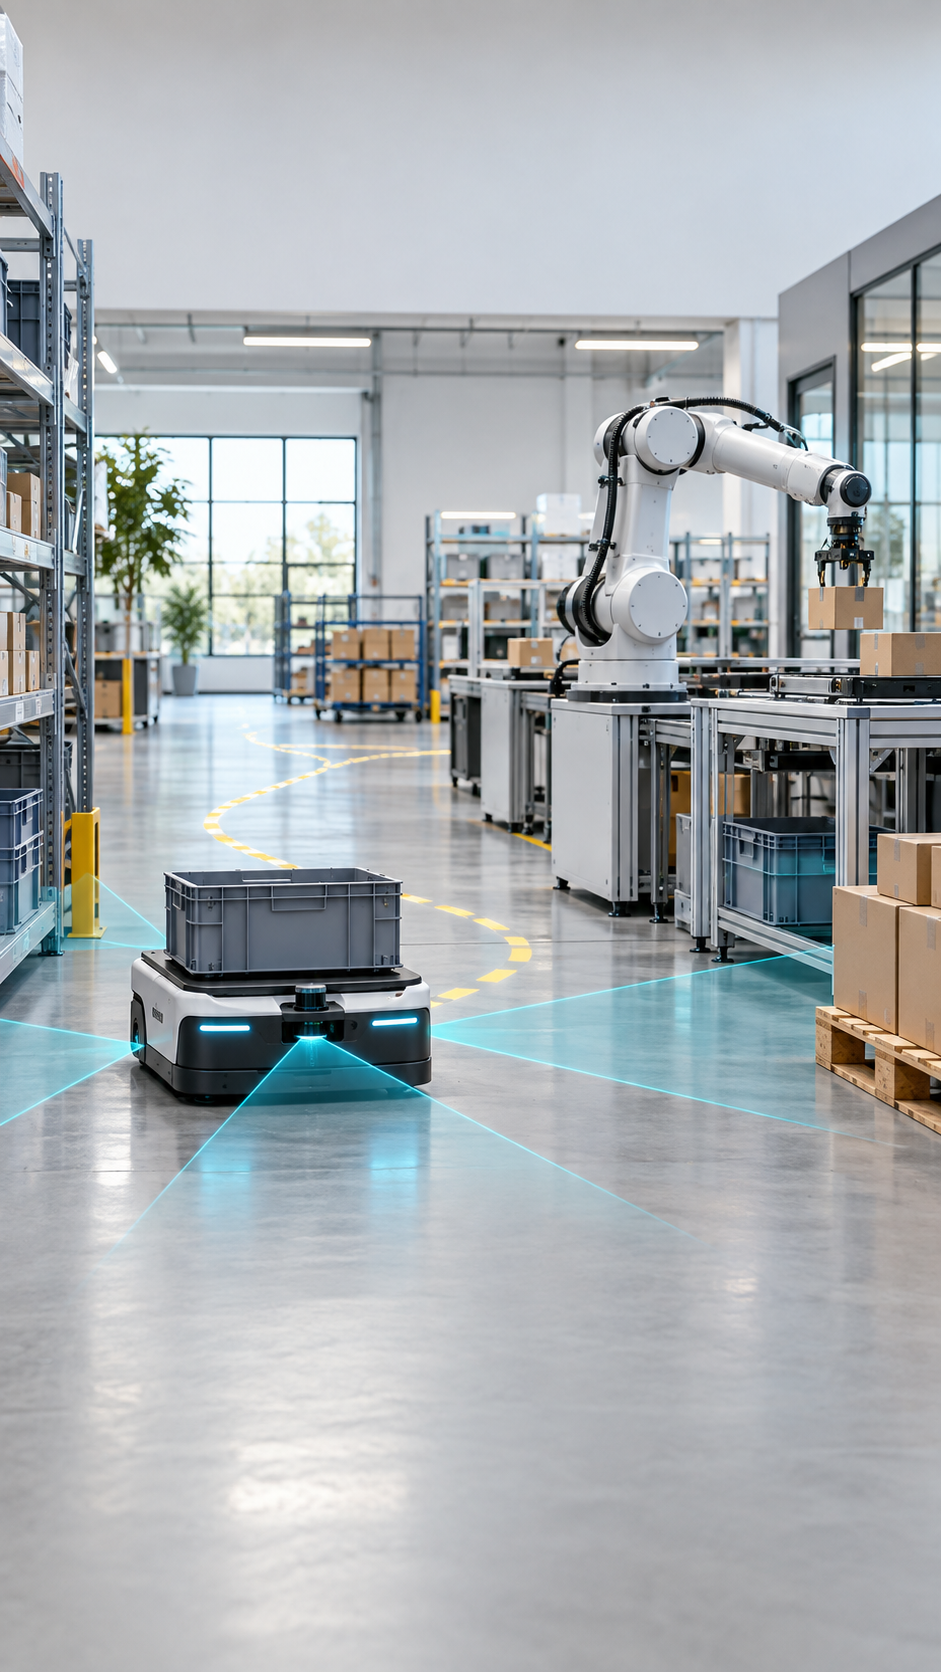
實體 AI 會從攝影機、距離感測器、麥克風、觸覺或機器本身的狀態取得資訊。這些資料不是裝飾,而是系統判斷「眼前有什麼、自己在哪裡、下一步可能碰到什麼」的依據。
例如掃地機器人遇到突然移動的椅子,倉儲機械臂面對位置略有偏移的紙箱,系統都要先辨認環境,而不是只照著事先寫死的座標動作。
第二步:判斷下一步怎麼做
取得資訊後,系統要把目標、環境與限制放在一起考量。它可能需要規劃路徑、拆解工作、判斷物件是否能抓,或在狀況改變時調整原本的計畫。
Google DeepMind 對機器人模型的說明提供了一個直觀例子:視覺與語言資訊可以被轉成馬達控制,讓機器人把「看見」與「理解指令」接到實際動作。這不代表所有 Physical AI 都使用同一種模型,但可以幫助我們理解它和一般聊天工具的差別。
第三步:在物理世界採取動作
Physical AI 的輸出可能是轉向、減速、抓取、放下、避開障礙或調整機械設備。這些動作會受到重力、摩擦、距離、延遲與硬體能力限制。
也因為如此,Physical AI 的錯誤成本通常比文字回答更直接。聊天工具答錯一句話,可以重新查證;機器若判斷錯距離,則可能碰撞物品或進入不安全區域。Google DeepMind 的公開安全資料因此強調語意、物理與操作等多層防護,而不是把安全寄託在單一模型上。
生活中可以怎麼理解?
可以把掃地機器人想成一個簡化例子:它用感測器看見障礙,判斷可走路線,再控制輪子改變方向。更複雜的系統可能是倉儲機械臂、自主移動機器人或車輛,它們面對的環境變化與安全要求也更高。
不過,會自動動作不一定就是 Physical AI。只按照固定時間啟動的設備,或只靠單一規則開關的自動門,未必包含學習、推理或情境調整。判斷關鍵不是外觀看起來多像機器人,而是系統是否真的把環境感知、情境判斷與物理行動接在一起。
為什麼現在值得認識這個名詞?
NVIDIA 在 2026 年 9 月 22 日開始的 ROSCon 2026 活動中,安排了機器人模擬、接觸式操作、ROS 2 與 Physical AI 相關內容。這不是某個通用型機器人突然完成的宣告,而是顯示業界正在持續補齊從模擬、訓練到真機部署的整套工程流程。
所以,下次看到「Physical AI」,先不要只想到人形機器人。更準確的問題是:這個系統如何感知環境、如何判斷,又能安全地做出什麼動作?
資料核對日期: 2026-09-21
作者與商業關係揭露: 本文由奧微軟體 AugurSoft 整理,屬 AI 技術知識內容;奧微提供軟體與 AI 導入相關服務。本文未接受文中公司付費,也不構成特定產品推薦。
配樂署名: Reel 使用 Carefree — Kevin MacLeod,來源 Incompetech,依 CC BY 4.0 授權,影片中進行剪輯與混音。
來源
- NVIDIA, Physical AI Learning
- Google DeepMind, Gemini Robotics
- Google DeepMind, Responsibly advancing AI and robotics
- NVIDIA, NVIDIA at ROSCon 2026