AI 知識
大上下文不等於真正的記憶
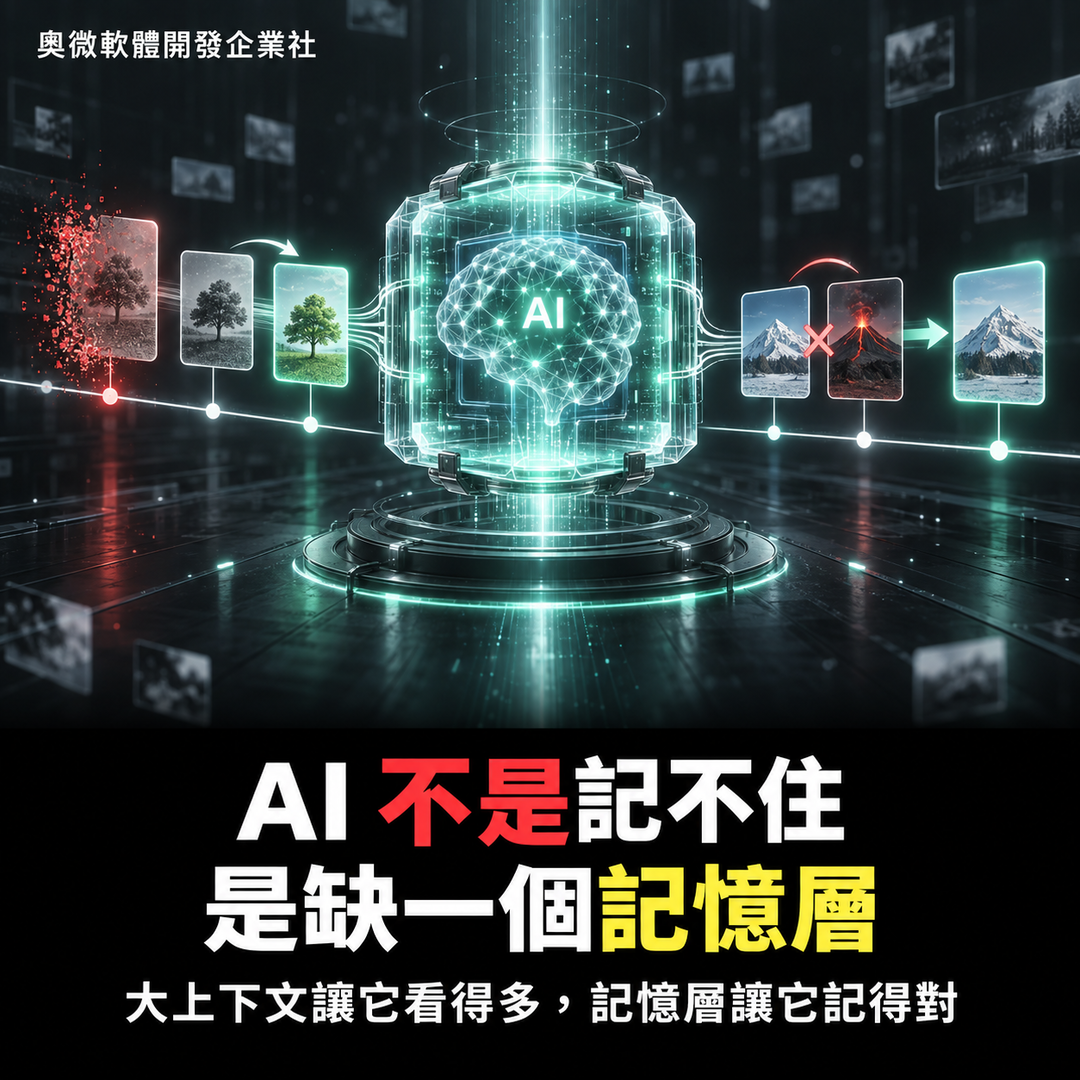
很多人以為,只要把 AI 的 context window 做得更大,它就會逐漸記住使用者。兩者其實不是同一件事。
Context window 解決的是「這次請求能看到多少內容」。只要文字還放得進去,模型就能參考;超出範圍、換了新會話,或應用程式沒有把舊內容重新帶回來,這些資訊就不一定還在。即使全部塞回去,模型仍可能同時看到互相矛盾的新舊資料。
真正的記憶層處理的是另一組問題:哪些資訊值得長期保存?哪一筆資料已經被更新?短期事件何時應該失效?回答問題時,該取回哪一小段,而不是把所有歷史重新灌給模型?
AI 記憶不只是「保存聊天紀錄」
Supermemory 將自己定位為 AI 的 memory and context layer。依官方文件,它會從對話中擷取事實、維護使用者輪廓、處理知識更新與矛盾,也會讓已過期的暫時資訊失效。
假設使用者三個月前說「我住在台中」,今天改口說「我搬到台北了」。一般檢索系統可能把兩句都找回來;有時間關係的記憶系統則應知道後者更新了前者。又例如「我明天要考試」具有明確時效,考試結束後就不該永遠被當成現在狀態。
這也是 memory 和一般 RAG 的差別。RAG 擅長從文件庫找出相關片段;memory 更關心使用者與事件如何隨時間改變。兩者可以一起使用,但不能只把向量搜尋改名成記憶。
95% Recall@15 代表什麼?
Supermemory 官方公開的 LongMemEval-S 報告顯示,在其指定評測設定中,系統達到 95% overall Recall@15,平均加入約 720 tokens;細項包含知識更新 99%、時間推理 91%、多會話 93%。這個基準特別測試跨會話回憶、偏好、資訊更新與時間推理。
這組數字的價值,在於它同時觀察「能否找到正確記憶」與「需要帶回多少 context」。如果為了答對一題而把全部歷史塞回模型,成本、延遲和雜訊都會增加。
但要注意,這些是 Supermemory 團隊公開的官方測試,不是任意產品都能直接套用的效果保證。評測使用的資料集、回答模型、judge、檢索參數與 Recall@k 定義都會影響結果。官方也公開 MemoryBench,讓不同記憶服務能在相同流程下比較正確率、延遲與 context tokens。
實際導入前,至少測四件事
第一,測「更新」而不只測「記住」。把同一個人的城市、職稱或偏好先後改掉,確認系統是否會優先使用新資訊。
第二,測「應該忘記」。暫時行程、一次性任務與敏感資訊,都要有到期、刪除與不再召回的機制。
第三,測「取回錯誤」。相似名字、相似專案或多人共用帳號時,記憶是否會串錯對象?
第四,分開看正確率、延遲與 token。單一總分很容易掩蓋代價;適合的系統必須在自己的真實資料上取得可接受的平衡。
更大的 context window 讓 AI 看得更多;真正的記憶層,則要讓 AI 在時間、更新與矛盾之間記得正確。下一次評估「AI 是否有記憶」時,不要只問它能保存多少字,更要問:記錯時能不能改、該忘時能不能忘、需要時能不能取回正確的一小段。
查證資料
- Supermemory 官方程式庫:https://github.com/supermemoryai/supermemory
- Supermemory LongMemEval-S 研究報告:https://supermemory.ai/research/longmembench/
- MemoryBench 官方程式庫:https://github.com/supermemoryai/memorybench
- 官方評測實務文章:https://supermemory.ai/blog/build-agent-memory-eval-harness/
查證日期:2026-09-22
回文章列表